

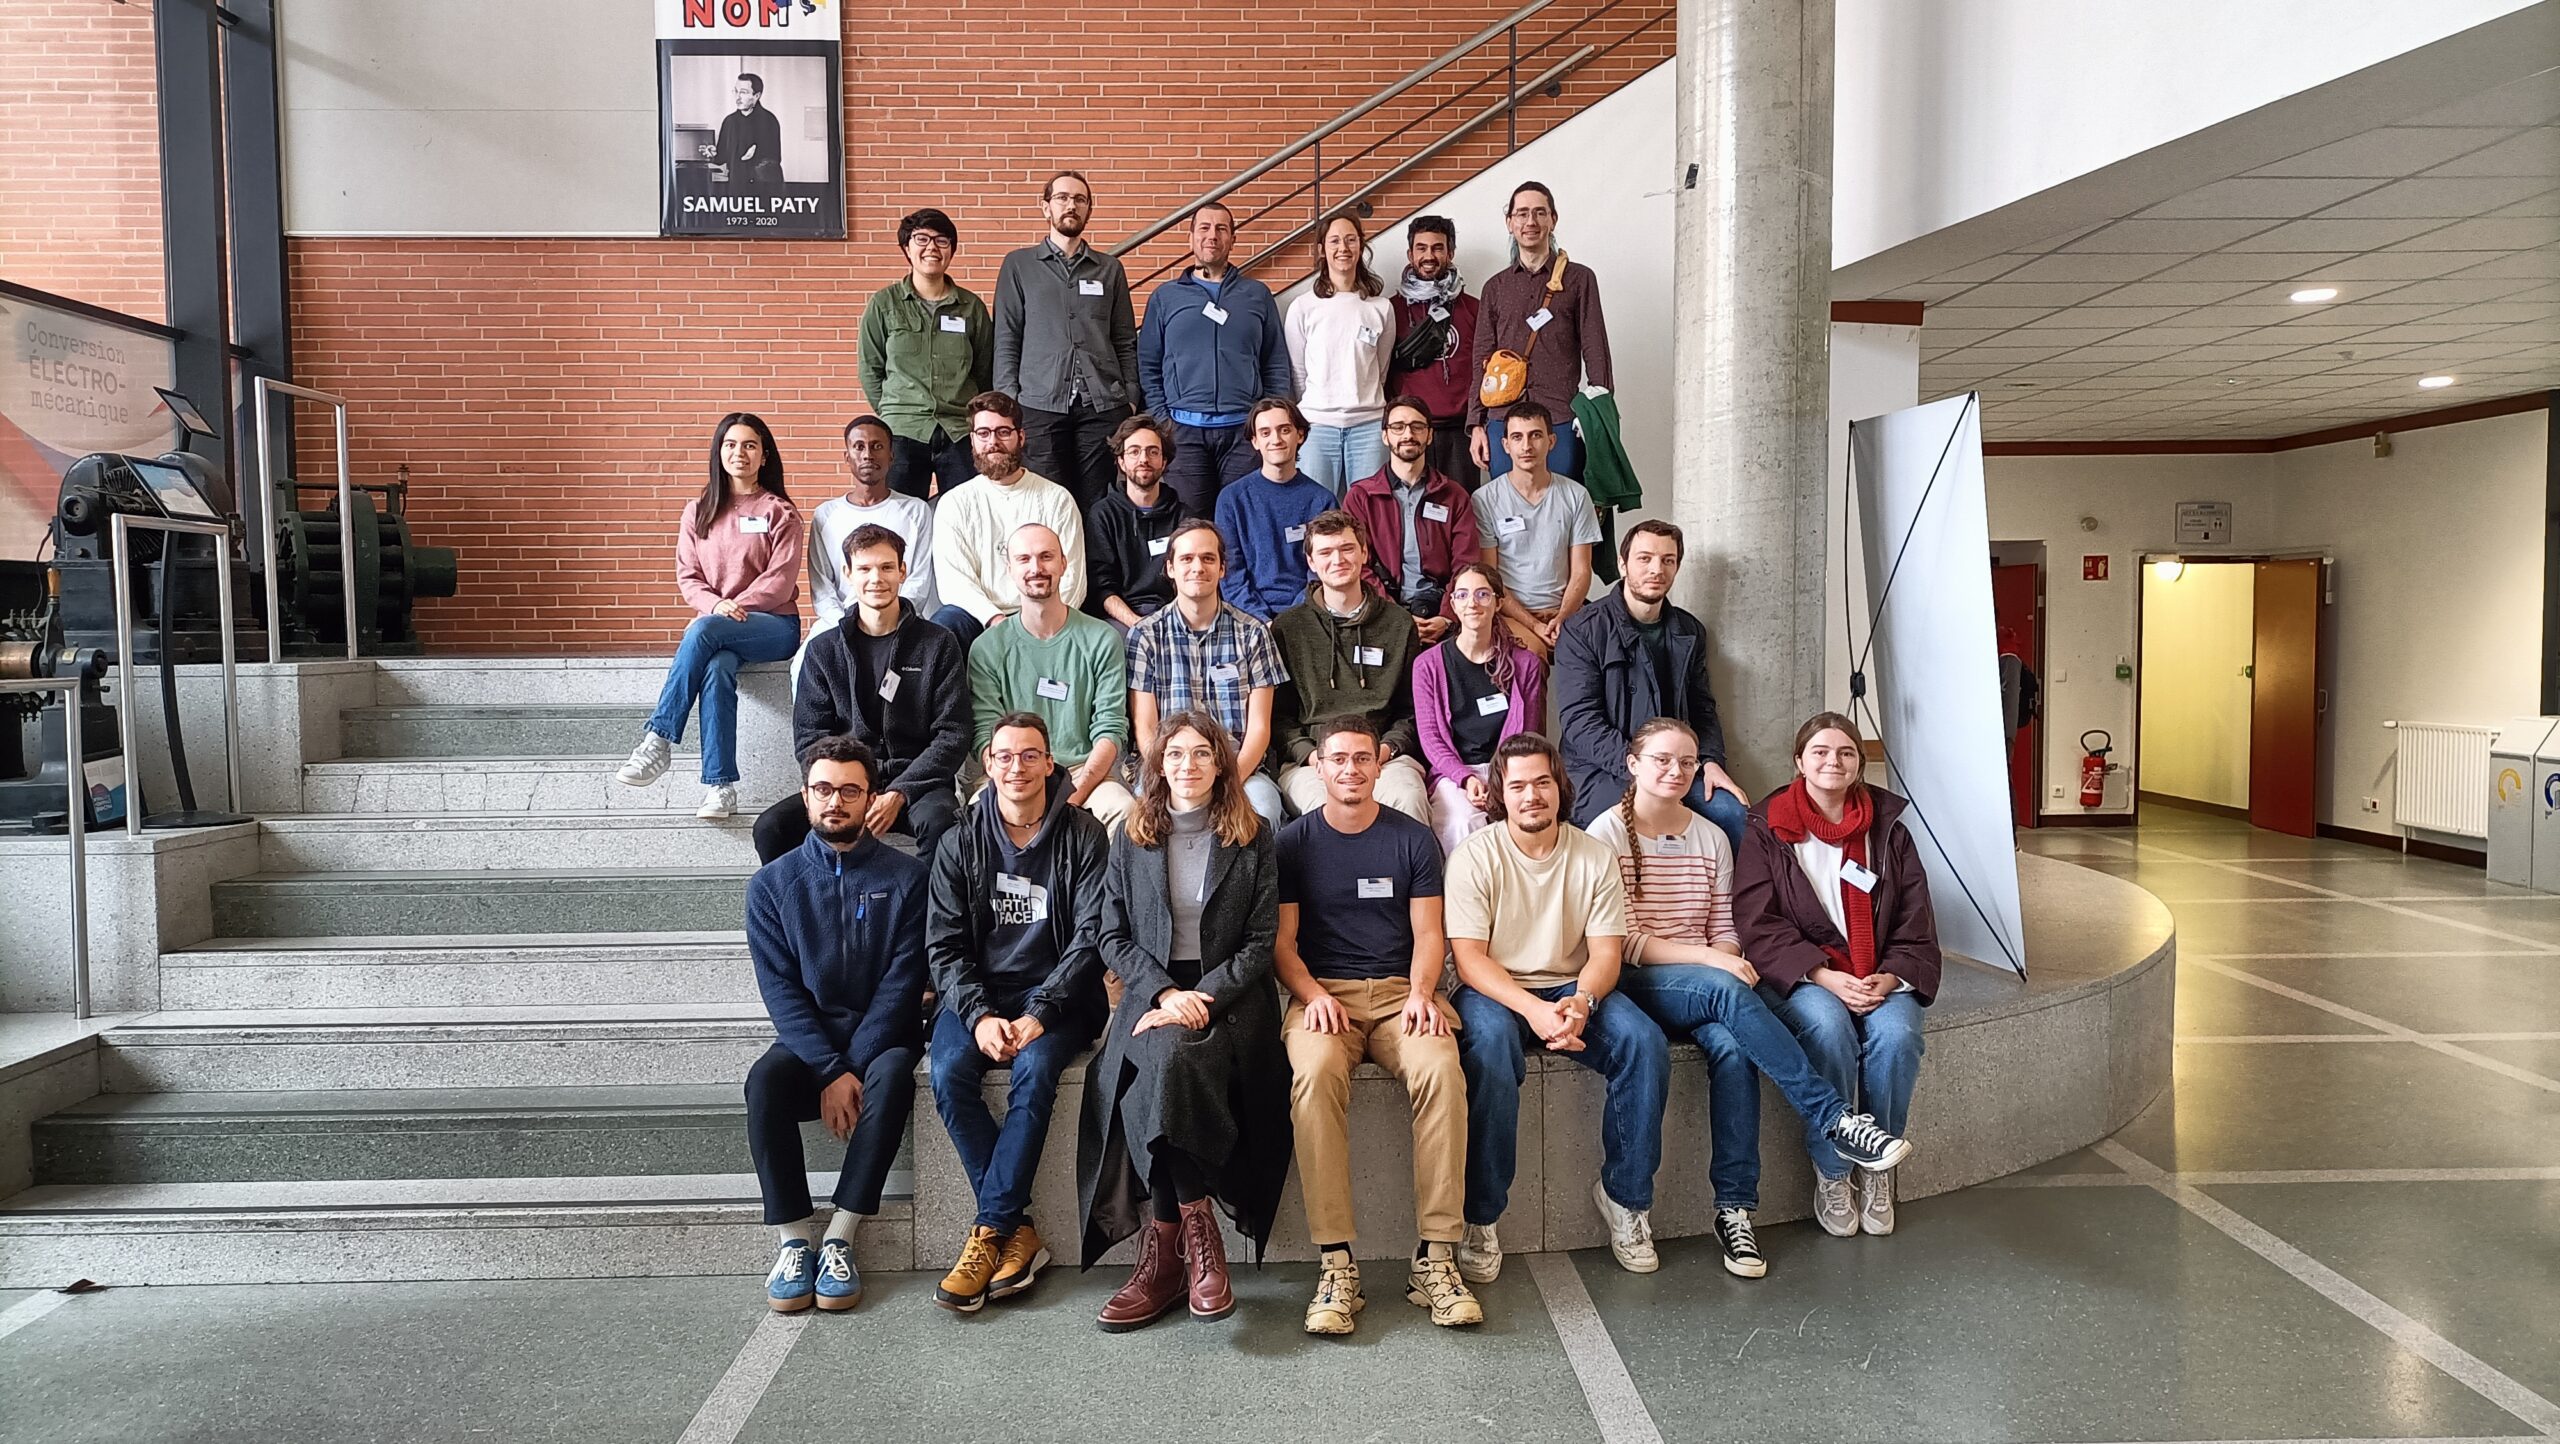
La première assemblée générale de YoungPEx
Le comité YoungPEx est une initiative de NumPEx visant à rassembler de jeunes chercheurs pour discuter de l’avenir du calcul à haute performance et de la science ouverte. Cet événement a été une première étape importante pour dynamiser le comité et parler de sujets qui seront essentiels à l’avenir. Plusieurs ateliers ont été organisés :
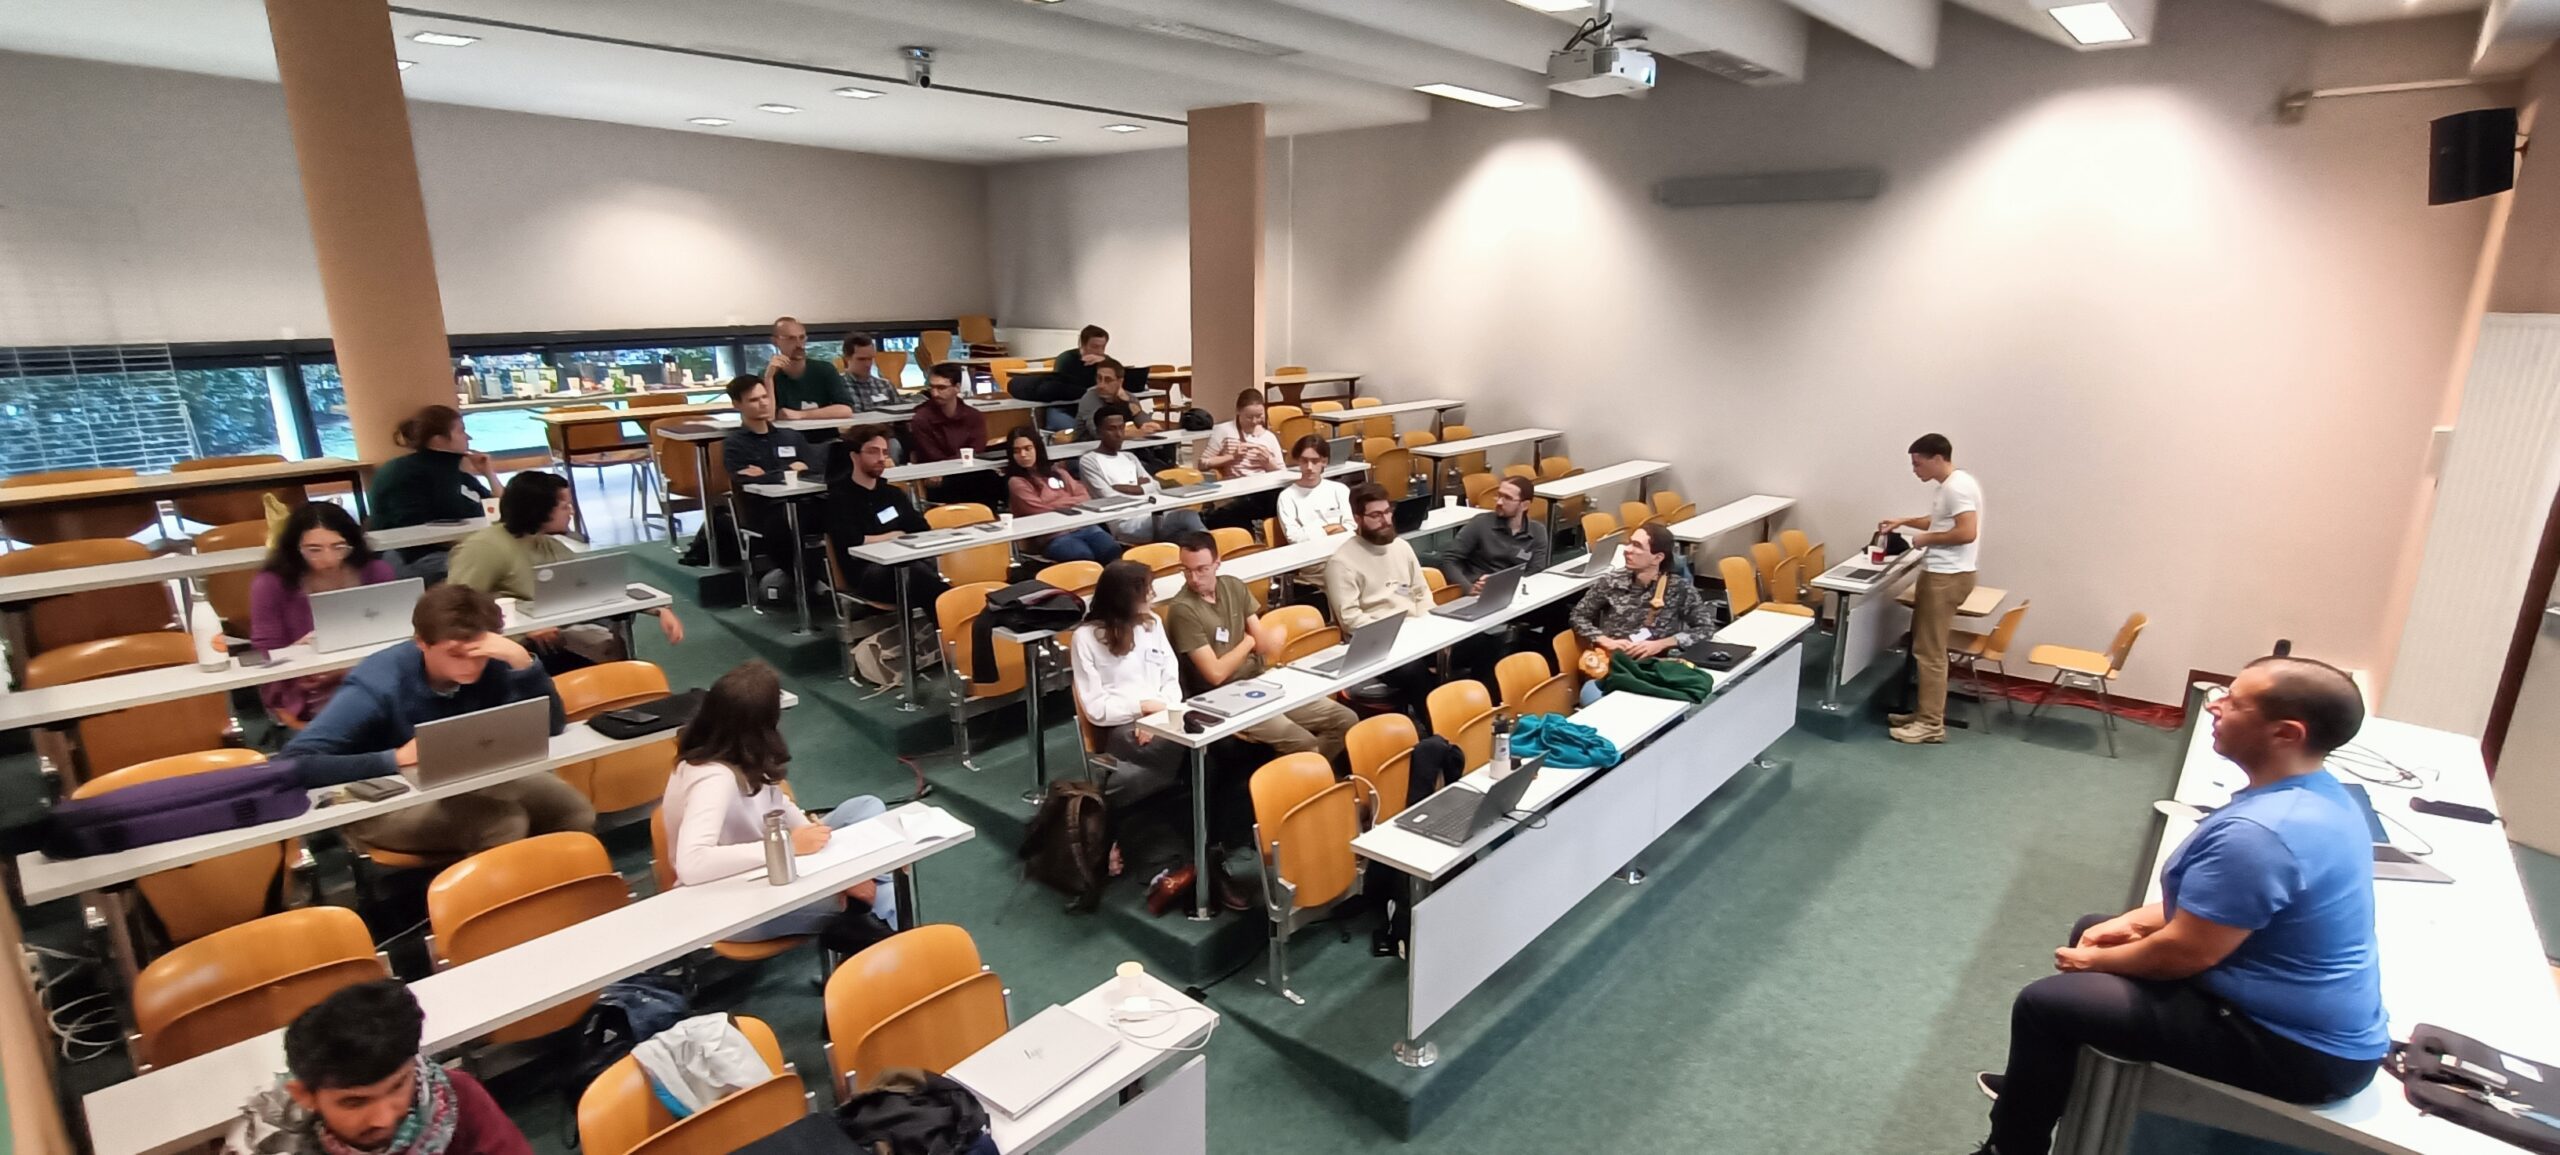
- Un atelier sur l’impact environnemental du HPC
animé par Georges Da Costa, professeur à l’Université de Toulouse et membre d’Exa-SoFt - Une assemblée générale pour discuter des actions à venir du comité YoungPEx et du renouvellement des membres organisateurs.
- Un atelier sur le thème des inégalités sociales et de genre
Mercredi 12 novembre 2025
Cette première journée d’atelier a été animée par Georges Da Costa, professeur à l’Université de Toulouse et membre d’Exa-SoFt.
- L’informatique durable ?
- Avenir du calcul haute performance : prochaines étapes pour le calcul haute performance ?
- Introduction à la grille 5000
Jeudi 13 novembre 2025
Cette deuxième journée a été l’occasion d’approfondir les thèmes de la première journée.
L’après-midi a été consacrée à rassembler les membres de la communauté, à échanger sur leurs travaux par le biais de nombreuses activités :
- Antithèse: Quatre présentations ont été préparées avant la journée, et quatre participants se sont portés volontaires pour la présenter, en découvrant les diapositives 5 minutes avant la présentation.
- Start-up nation : les participants ont été divisés en quatre groupes et ont dû créer une présentation d’une start-up ou d’un projet de recherche qui susciterait l’intérêt de tous les membres.
- Retour d’information sur l’atelier et émergence d’idées
- Idées pour les actions futures de YoungPEx.
Vendredi 14 novembre 2025
Le dernier jour, le thème principal était l’équité et l’égalité dans les sciences. Trois sessions différentes ont été organisées :
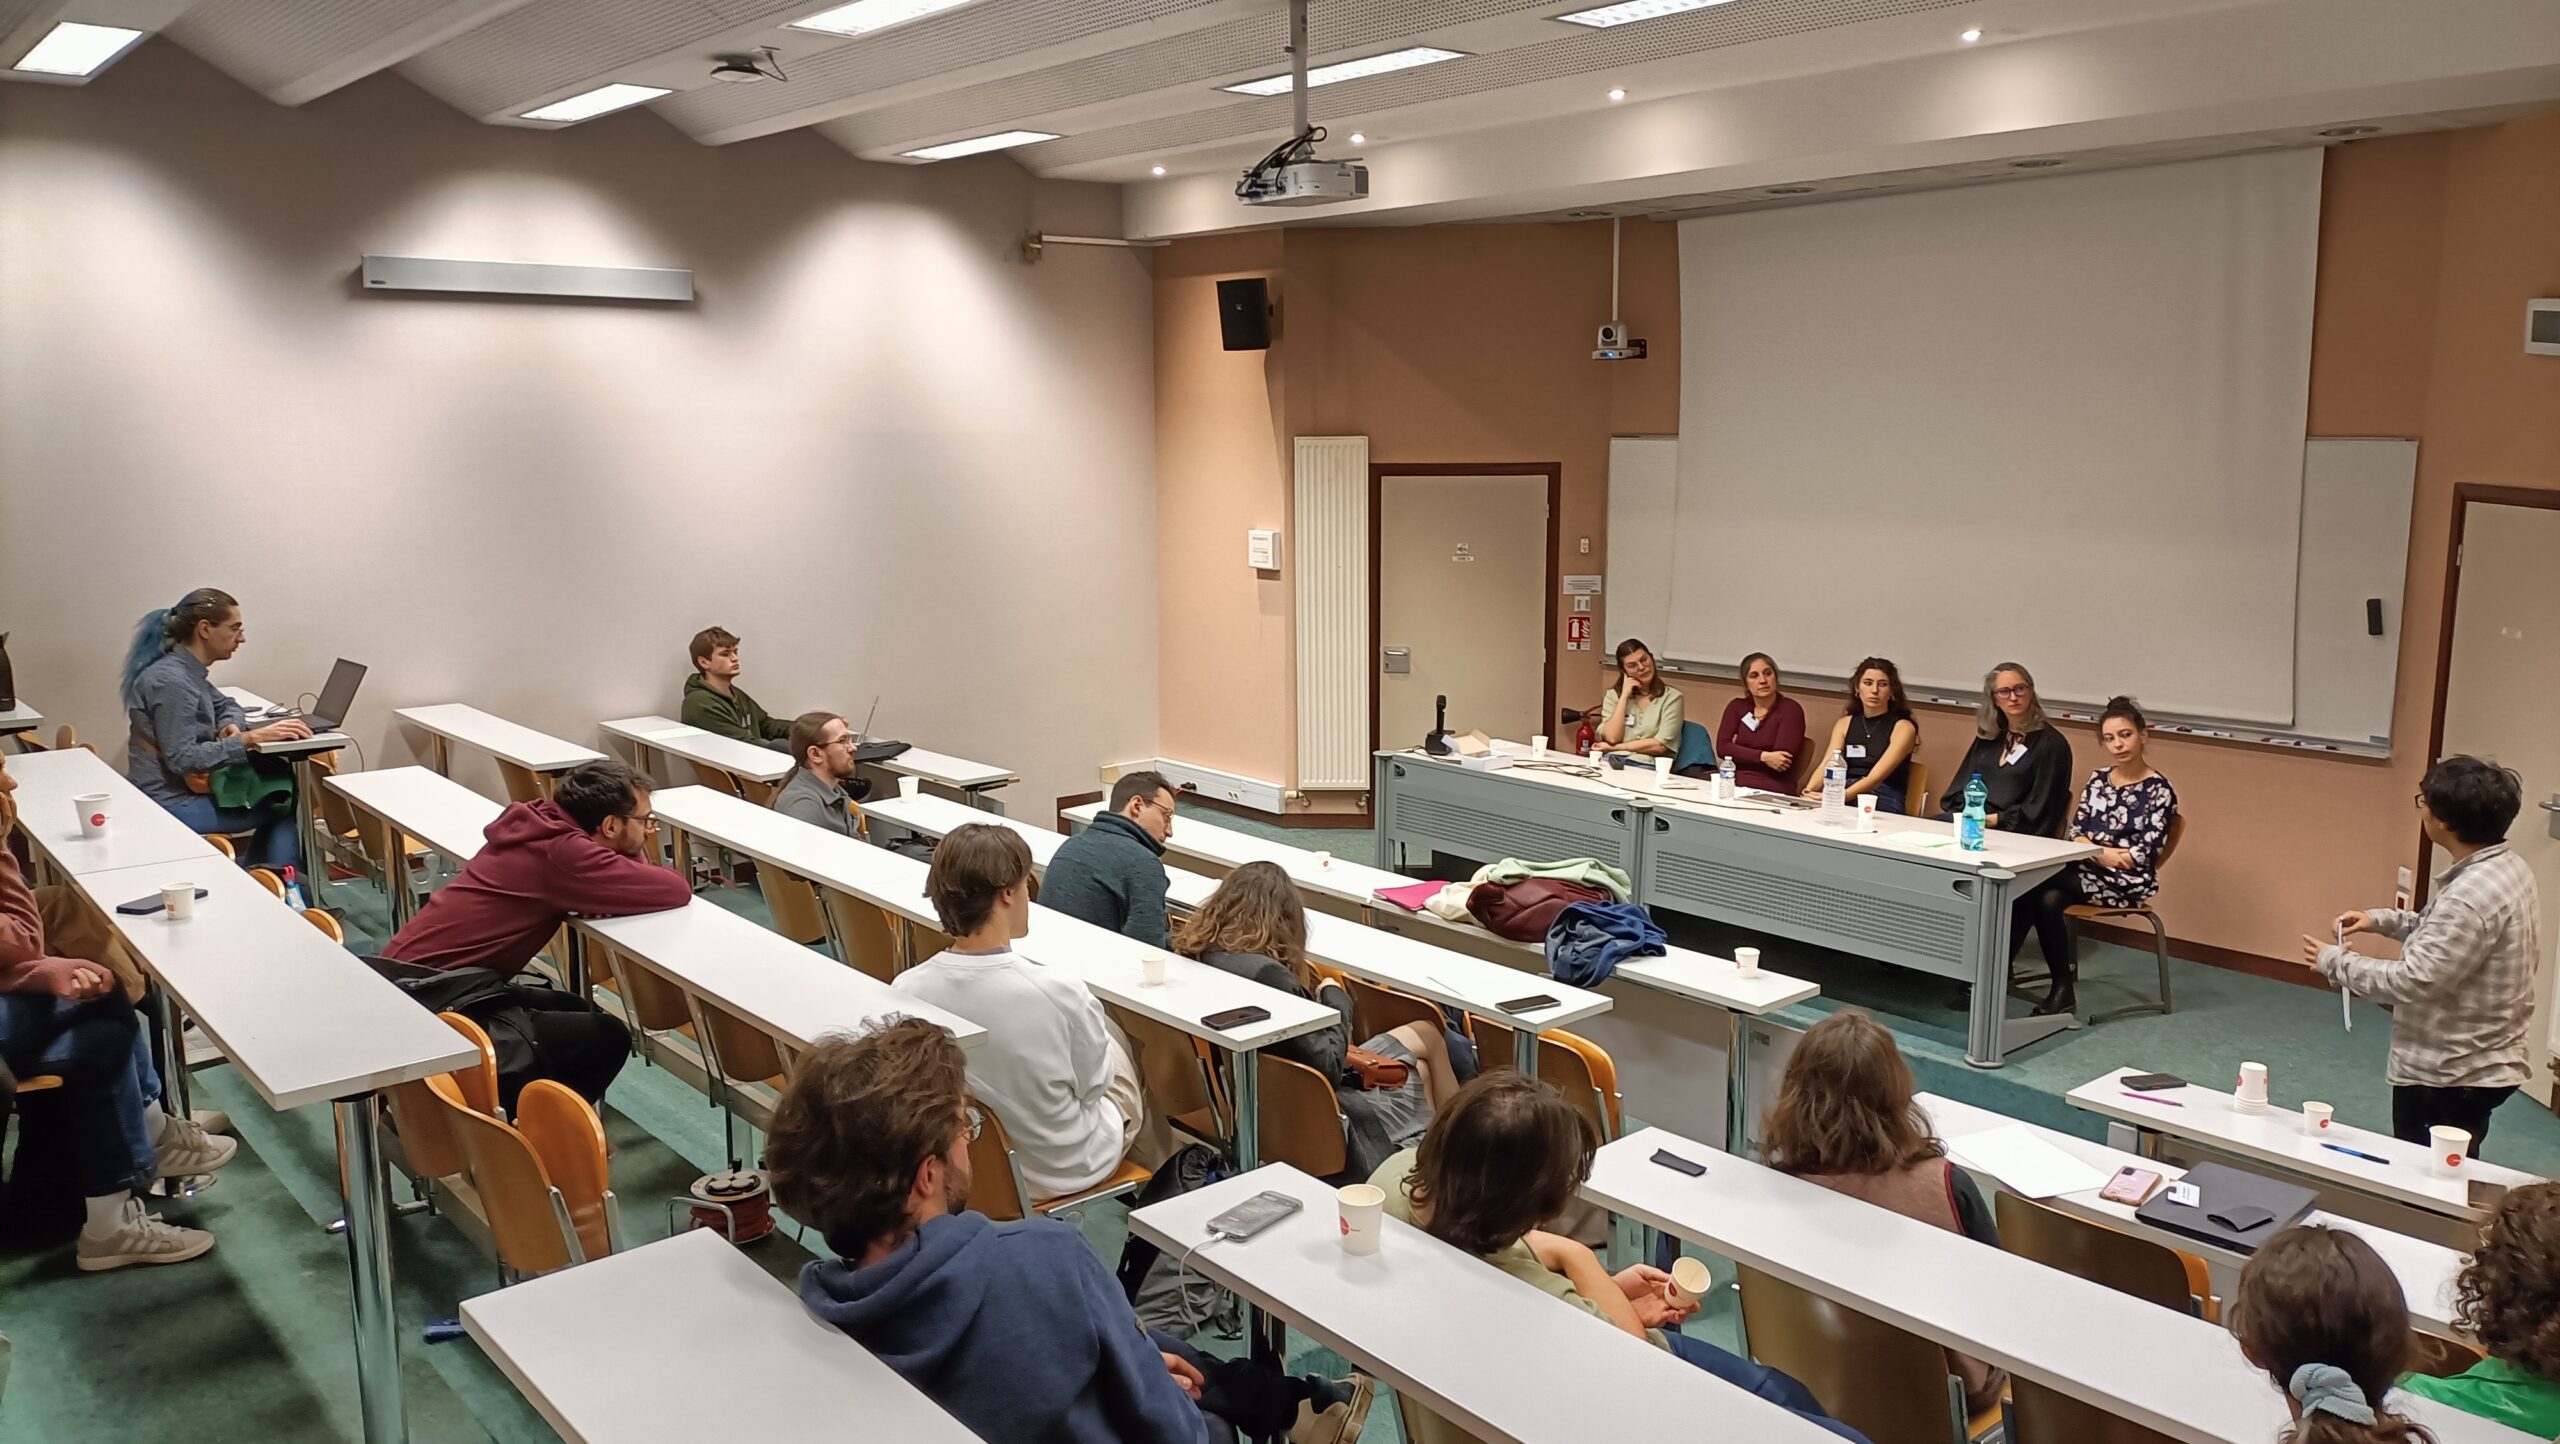
- le Monopoly des inégalités, un jeu inspiré du célèbre Monopoly, destiné à mettre en évidence le fait que tout le monde n’a pas les mêmes chances de réussir, animé par Yasmina Asso de l’Observatoire des inégalités;
- Présentation par Julie Lesthelle, de l’Université de Bordeaux, des résultats de son mémoire de master intitulé Les études en licence de mathématiques sous le prisme du genre : Construction d’un environnement masculin et expériences des étudiantes en situation minoritaire.
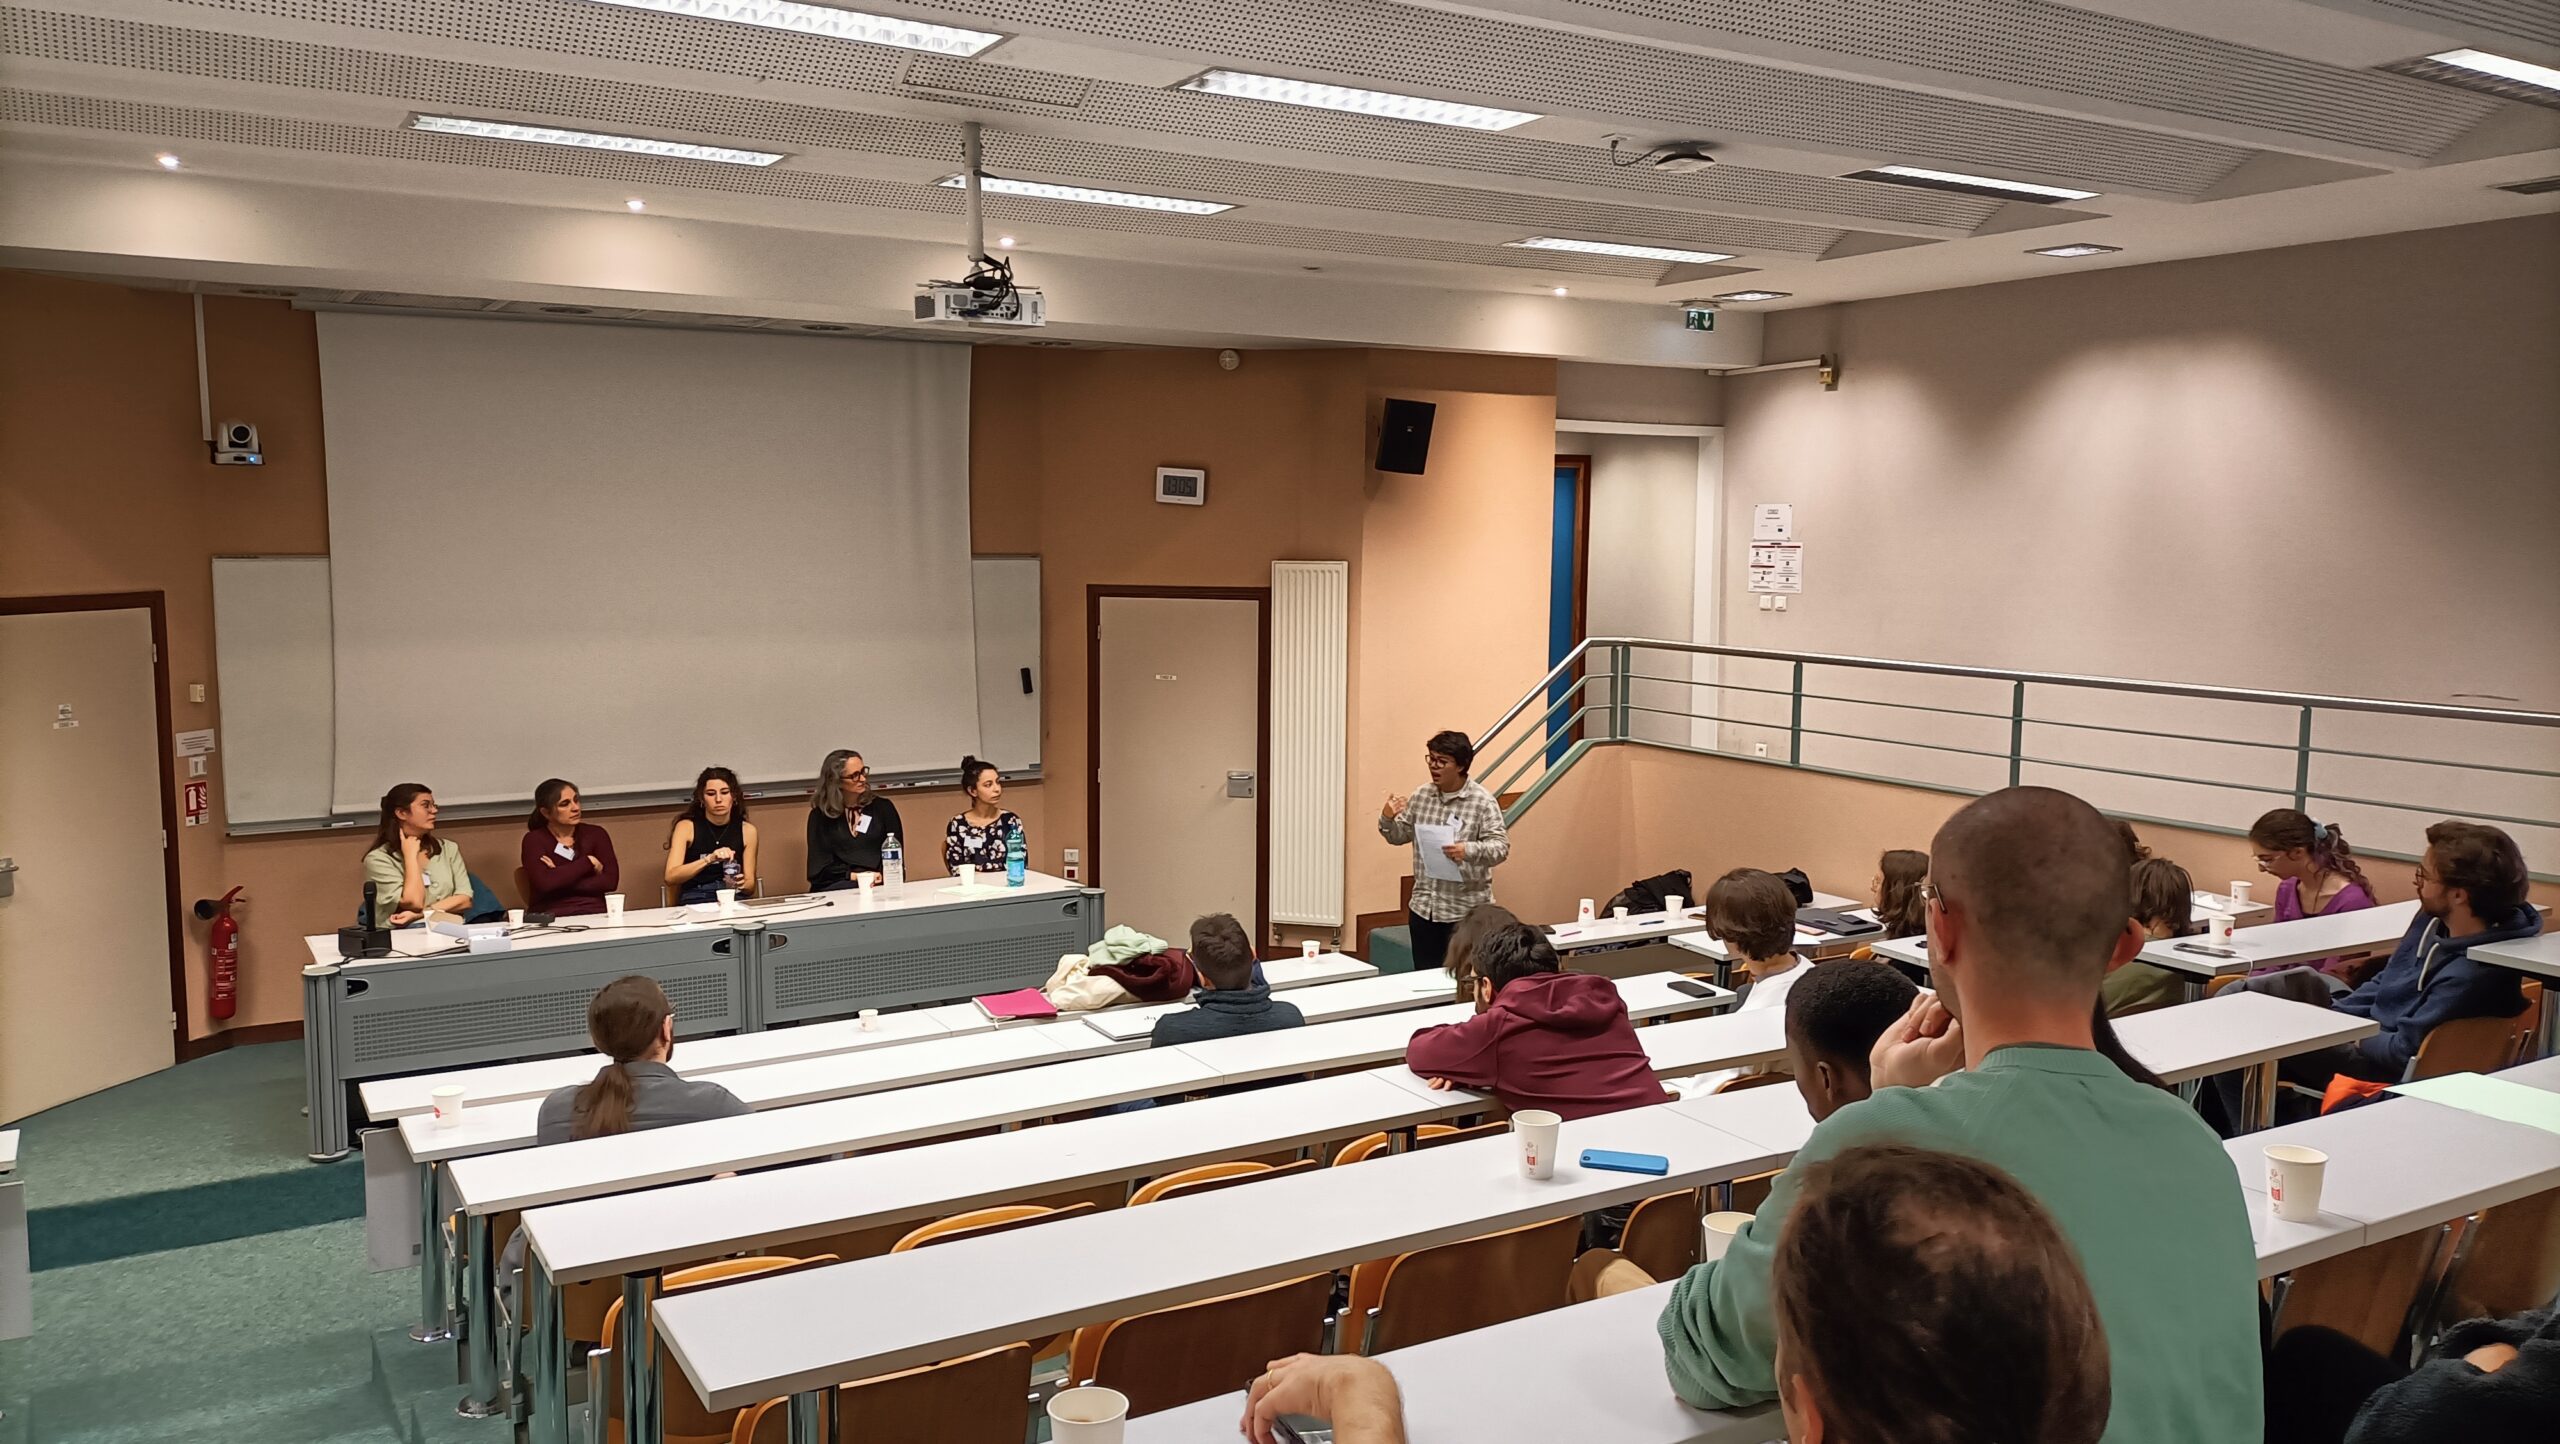
- Une table ronde sur le concept de leaking pipeline, avec l’intervention d’Elsa Cazelles (Chargée de Recherche à l’IRIT), Sylvie Chambon (Professeure des Universités à ENSEEIHT), Julie Lesthelle (étudiante à l’Université de Bordeaux), Lucie Baudouin (Directrice de Recherche au LASS) et Aline Roc (ingénieure de recherche au CATIE).
Ces sessions ont permis de faire le point sur la question de l’égalité et de l’équité et de formuler des recommandations et des signaux d’alerte pour identifier ou prévenir d’autres inégalités au sein de la communauté NumPEx.
Comité d'organisation
- Thomas Saigre, postdoctorant Inria à l’IRMA et membre d’Exa-MA
- Karmijn Hoogveld, doctorant CNRS à l’IRIT et membre d’Exa-SofT
- Méline Trochon, doctorante Inria au LaBRI et à Exa-DoST
- Mathis Certenais, doctorant de l’Université de Rennes à l’Irisa et membre d’Exa-AtoW
- Romain Garbage, ingénieur Inria et membre d’Exa-DI
Les organisateurs tiennent à remercier tous les participants à cet événement, ainsi que Georges Da Costa, Yasmina Asso, Julie Lesthelle, Elsa Cazelles, Sylvie Chambon, Lucie Beaudouin et Aline Roc pour leur temps et leur participation aux différentes activités !
Karmijn Hoogveld, Alfredo Buttari

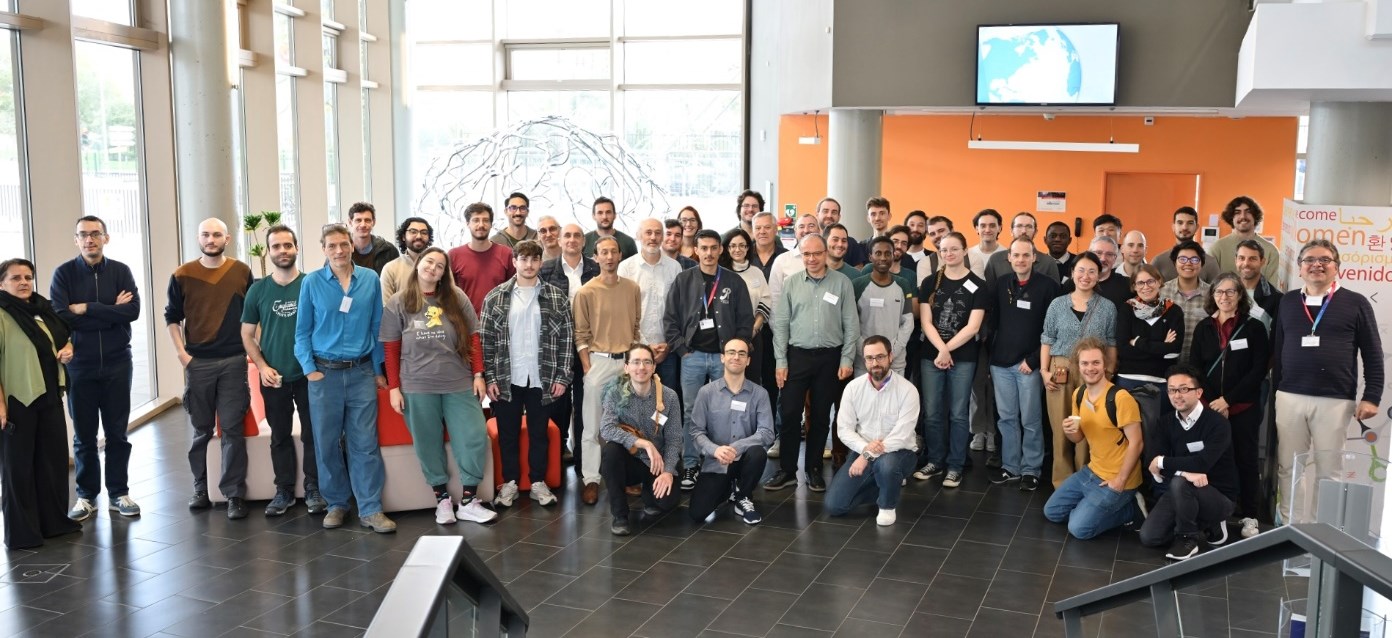
L'assemblée générale d'Exa-DoST 2025
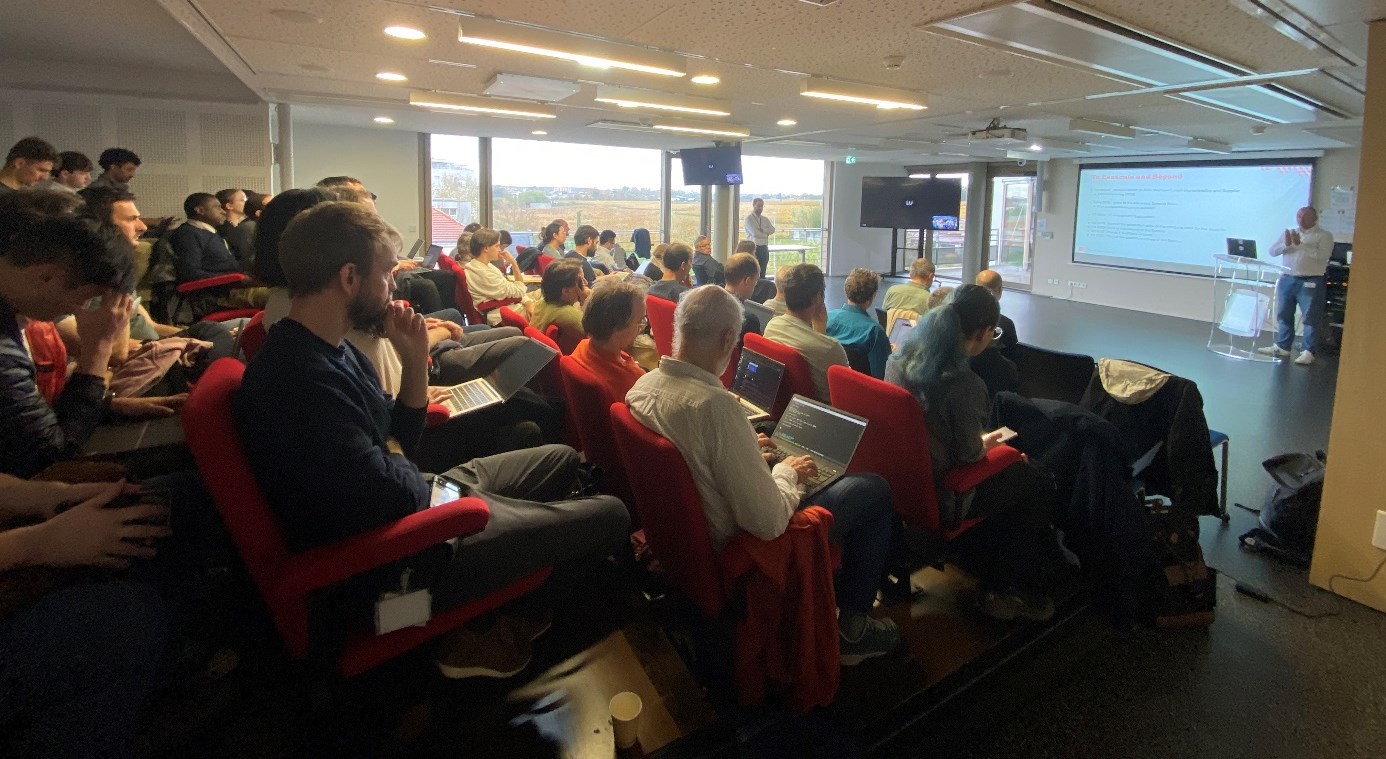
L’assemblée annuelle d’Exa-DoST 2025 s’est tenue du 5 au 7 novembre 2025, réunissant 65 chercheurs et ingénieurs du monde universitaire et de l’industrie pour discuter des dernières avancées, préparer les jalons des work packages, et accueillir les dernières recrues.
Exa-DoST (Data-oriented Software and Tools for the Exascale) est l’un des cinq projets du programme NumPEx. Exa-DoST aborde les grands défis liés aux données en proposant des solutions opérationnelles co-conçues et validées dans des applications françaises et européennes. Cela permettra de combler le vide laissé par les projets internationaux précédents afin de garantir que les besoins français et européens soient pris en compte dans les feuilles de route pour la construction de la pile logicielle Exascale axée sur les données.
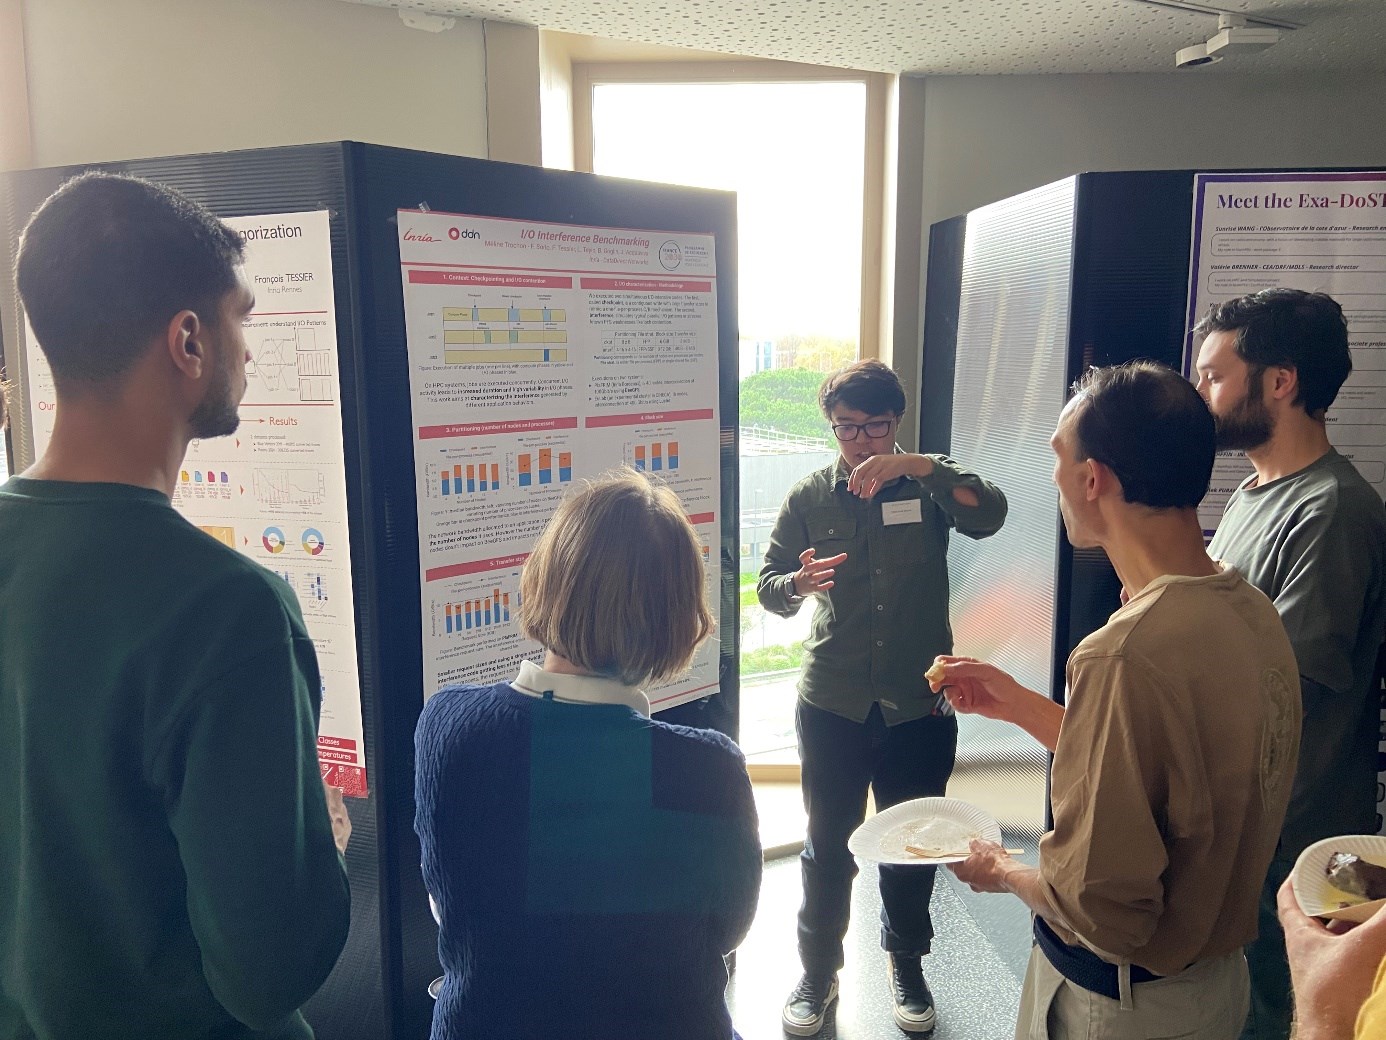
Enfin, Exa-DoST a été fière d’accueillir ses nouvelles recrues, qui ont brillamment relevé le défi de présenter des faits scientifiques marquants en sessions plénières et par le biais de sessions de posters !
Mercredi 5 novembre 2025
- Une introduction ou un rafraîchissement à NumPEx et Exa-DoST
par Gabriel Antoniu, chercheur Inria et co-leader Exa-DoST
et Julien Bigot, chercheur CEA et co-leader Exa-DoST - Quelques mots d’introduction pour tous
par Gabriel Antoniu et Julien Bigot - Premiers résultats et 2 axes scientifiques pour les lots de travail :
- WP1 – E/S et stockage de données
par Francieli Boito, chercheur à l’Inria et responsable du WP Exa-DoST
et François Tessier, chercheur à l’Inria et responsable du WP Exa-DoST - WP2 – Traitement des données in situ
par Yushan Wang, chercheur au CEA et responsable du WP Exa-DoST
et Laurent Colombet, chercheur au CEA et responsable du WP Exa-DoST - WP3 – ML-based data analytics
par Thomas Moreau, chercheur à l’Inria et responsable du WP Exa-DoST
et Bruno Raffin, chercheur à l’Inria et responsable du WP Exa-DoST - WP4 :
par Virginie Grandgirard, chercheur au CEA et responsable du WP Exa-DoST
et Damien Gratadour, professeur à l’Université Paris Cité et responsable du WP Exa-DoST.
- WP1 – E/S et stockage de données
Jeudi 6 novembre 2025
-
Intervention de François Mazen, Kitware
-
Exposé de Xavier Delaruelle, TGCC
- Séances en petits groupes :
- Retour d’expérience sur Gysela x WP1
Dirigé par Virginie Grandgirard, Francieli Boito et François Tessier - Feedback sur SKA x WP2
Dirigé par Damien Gratadour et Yushan Wang, avec la participation de Shan Mignot - Feedback sur d’autres applications (Coddex, Dyablo…) x WP3
Dirigé par Laurent Colombet, Thomas Moreau et Brunon Raffin - Retour d’expérience sur Gysela x WP2
Virginie Grandgirard, Yushan Wang et Laurent Colombet - Feedback sur SKA x WP3
Dirigé par Damien Gratadour, Thomas Moreau et Bruno Raffin - Retour d’information sur d’autres applications (Coddex, Dyablo…) x WP1
Dirigé par Laurent Colombet, Francieli Boito et François Tessier
- Retour d’expérience sur Gysela x WP1
Vendredi 7 novembre 2025
-
Comment aborder la modularité dans la conception des bibliothèques au sein d’Exa-DoST ?
par Julien Bigot - Séances en petits groupes :
- Feedback sur Gysela x WP3
Dirigé par Virginie Grandgirard, Thomas Moreau et Bruno Raffin - Retour d’information sur SKA x WP1
Dirigé par Damien Gratadour, Francieli Boito et François Tessier - Feeback sur d’autres applications (Coddex, Dyablo…) x WP2
Dirigé par Laurent Colombet et Yushan Wang
- Feedback sur Gysela x WP3
- Résumé des sessions en petits groupes avec tous les lots de travail :
Participantes et participants
- Mahamat Abdraman, Inria
- Jean-Thomas Acquaviva, DDN
- Gabriel Antoniu, Inria
- Julian AURIAC, CEA
- Rosa Maria Badia, BSC
- Alexis Bandet, Inria
- Iheb Becher, CNRS
- Mansour Benbakoura, Inria
- Andres Bermeo Marinelli, Inria
- Julien Bigot, CEA
- Jérôme Bobin, CEA
- François Bodin, Irisa
- Francieli Boito, Université de Bordeaux
- Robin Boezennec, Inria
- Etienne Bonnassieux, Université de Bordeaux
- Eric Boyer, Genci
- Valérie Brenner, CEA
- Silvina Caino-Lores, Inria
- Franck Cappello, Laboratoire national d’Argonne, en ligne
- Pierre Cesar, Inria
- Jérôme Charousset, CEA
- Mathieu Cloirec, CINES
- Arnaud Collioud, Université de Bordeaux
- Laurent Colombet, CEA
- Marwane Dalal, Laboratoire d’Astrophysique de Bordeaux
- Ariel De Vora, CEA
- Xavier Delaruelle, CEA
- Arnaud Durocher, CEA
- Sofya Dymchenko, Inria
- Hugo Gaquere, Observatoire de Paris
- Virginie Grandgirard, CEA
- Damien Gratadour, Université Paris Cité
- Amina Guermouche, Inria
- Gabriel Hautreux, CINES, en ligne
- Hadrien Hendrikx, Inria
- Arthur Jaquard, Inria
- Théo Jolivel, Inria
- Sylvain Joube, CEA
- Ivan LUCAS, CEA
- Jakob Luettgau, Inria
- Martial Mancip, CEA
- Benoit Martin, CEA
- François Mazen, Kitware
- Yann Meurdesoif, CEA
- Shan Mignot, CNRS
- Thomas Moreau, Inria
- Jacques Morice, CEA
- Étienne Ndamlabin, Inria
- Guillaume Pallez, Inria
- Lucas Pernollet, CEA
- Abhishek Purandare, Inria
- Bruno Raffin, Inria
- Olivier Richard, Université Grenoble Alpes
- Kento Sato, Riken
- Hugo Strappazzon, Inria
- Frédéric Suter, Laboratoire national d’Oak Ridge, en ligne
- François Tessier, Inria
- Samuel Thibault, Université de Bordeaux
- Luan Teylo, Inria
- Alix Tremodeux, ENS Lyon
- Méline Trochon, Inria
- Hippolyte Verninas, Inria
- Sunrise Wang, CNRS
- Yushan Wang, CEA
- Jad Yehya, Inria
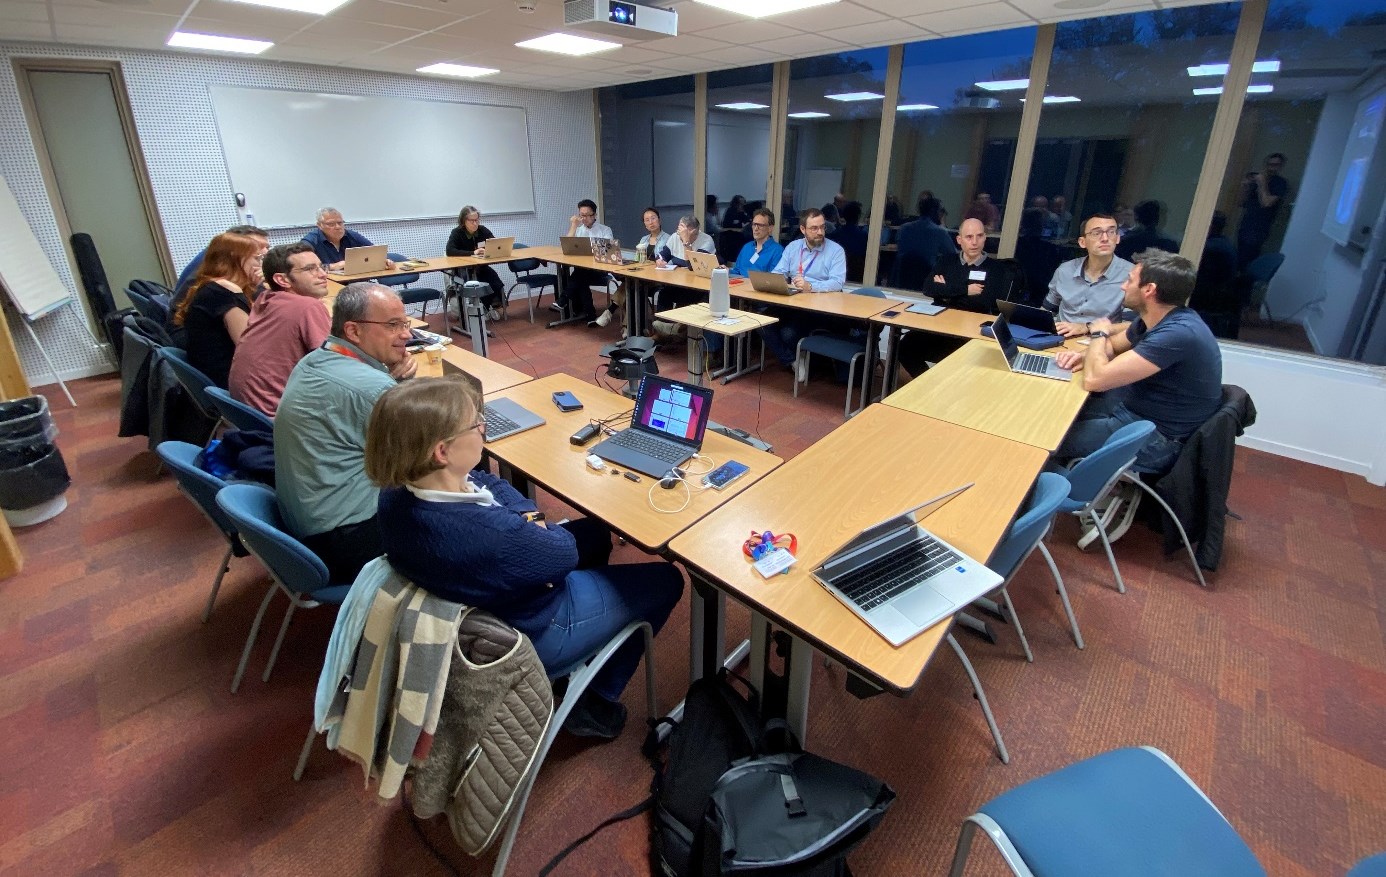
©Martial Mancip / PEPR NumPEx
Exa-DI : la première mini-application issue du co-développement est désormais disponible !
Suite aux réunions générales d’Exa-DI, des groupes de travail ont été constitués pour produire des applications sur quatre thèmes majeurs. La première mini-application sur la discrétisation de haute précision est maintenant disponible.
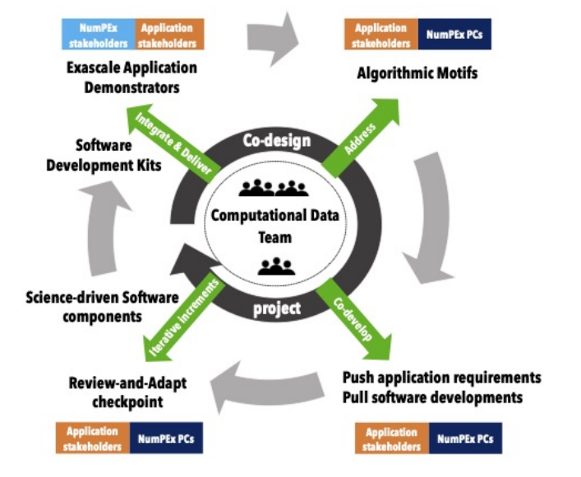
Suite aux ateliers Exa-DI, quatre groupes de travail (GT) ont été constitués, réunissant tous les acteurs impliqués dans la co-conception et le co-développement : l’équipe Computational and Data Science (CDT) d’Exa-DI, les membres des différents projets NumPEx ciblés et les équipes de démonstration d’applications. Ces groupes se concentrent sur la discrétisation efficace, les maillages non structurés, l’AMR structurée par blocs et l’IA appliquée aux problèmes inverses linéaires à l’échelle exascale.
Grâce à ces groupes de travail, les premières mini-applications partagées, représentatives des défis techniques des applications exascales, sont en cours de développement. Elles intègrent des composants logiciels à forte valeur ajoutée (bibliothèques, frameworks, outils) fournis par d’autres équipes NumPEx. Dans ce contexte, la première mini-application sur la discrétisation de haute précision est maintenant disponible, et d’autres suivront bientôt.
Un hub documentaire, mis en place début 2025, centralise progressivement les tutoriels et documents techniques d’intérêt général pour NumPEx Exa-DI. Il comprend : le catalogue du logiciel NumPEx, des webinaires et des formations, de la documentation sur la co-conception et le packaging CDT, et bien d’autres choses encore.
N’hésitez pas à le consulter pour vous tenir au courant des outils et des ressources disponibles.
Figure : Vue d’ensemble d’Impact-HPC.
PEPR NumPEx

Exa-DI : Faciliter le déploiement d'applications HPC avec les gestionnaires de paquets
Exa-DI est fier de présenter sa série de formations destinées aux utilisateurs de package managers, conçues pour optimiser leur expérience d’utilisation.
Le déploiement et le portage d’applications sur des supercalculateurs reste une tâche complexe et fastidieuse. NumPEx encourage les utilisateurs à utiliser des gestionnaires de paquets, permettant un contrôle précis et direct de leur pile logicielle, avec un accent particulier sur Guix et Spack.
Une série de cours de formation et d’événements de soutien a été organisée pour aider les utilisateurs :
– Tutoriel : Introduction à Guix – Octobre 2025
– Tutoriel @ Compass25 : Guix-deploy – Juin 2025
– Coding session : Publication de paquets sur Guix-Science – Mai 2025
– Tutoriel : Spack pour les débutants (en ligne) – Avril 2025
– Tutoriel : Utiliser Guix et Spack pour déployer des applications sur des supercalculateurs – Février 2025
Le passage à de nouvelles méthodes de déploiement prend du temps. NumPEx soutient les utilisateurs en proposant des formations, une assistance, un packaging logiciel, des améliorations d’outils et des partenariats avec des centres de calcul pour optimiser l’expérience de l’utilisateur.
Pour plus d’informations : https://numpex-pc5.gitlabpages.inria.fr/tutorials/webinar/index.html
Crédit photo : Mohammad Rahmani / Unsplash
Exa-DI : la co-conception et le co-développement dans NumPEx progressent
La mise en œuvre du processus de co-conception et de co-développement au sein de NumPEx est l’un des objectifs d’Exa-DI pour la production de logiciels augmentés et productifs. A cette fin, Exa-DI a organisé trois groupes de travail ouverts à tous les membres du NumPEx.
Le projet Exa-DI est chargé de mettre en œuvre le processus de co-conception et de co-développement au sein de NumPEx, dans le but de produire des logiciels exascales augmentés et productifs, orientés vers la science. Dans ce contexte, Exa-DI a déjà organisé trois ateliers: un sur la discrétisation efficace pour les EDP exascales, un autre sur l’AMR structuré par blocs à l’échelle exascale et un troisième sur l’intelligence artificielle pour le HPC exascale. Ces ateliers de deux jours en personne ont rassemblé des membres d’Exa-DI, des membres d’autres projets NumPEx, des équipes présentant des applications issues de divers secteurs de la recherche et de l’industrie, ainsi que des experts.
Les discussions ont porté sur les points suivants
-
- Défis liés au processus de co-conception et de co-développement
- Questions clés
- Les questions les plus urgentes pour le développement collectif et le renforcement des liens entre NumPEx et les applications
- Initiatives visant à promouvoir la durabilité des logiciels exascales et la portabilité des performances.
Un résultat très intéressant et stimulant a été la création de groupes de travail axés sur un ensemble de mini-applications partagées et bien spécifiées représentant les modèles transversaux de calcul et de communication identifiés. Plusieurs équipes d’application ont exprimé leur intérêt à participer à ces groupes. À ce jour, quatre groupes de travail sont activement engagés dans la co-conception et le co-développement de mini-applications, en vue d’intégrer et d’évaluer les ensembles logiques de composants logiciels développés dans les projets NumPEx.
Stratégie pour l'interopérabilité des infrastructures scientifiques numériques
L’évolution des volumes de données et des capacités de calcul est en train de remodeler le paysage numérique scientifique. Pour exploiter pleinement ce potentiel, NumPEx et ses partenaires développent une stratégie d’interopérabilité ouverte reliant les principaux instruments, centres de données et infrastructures de calcul.
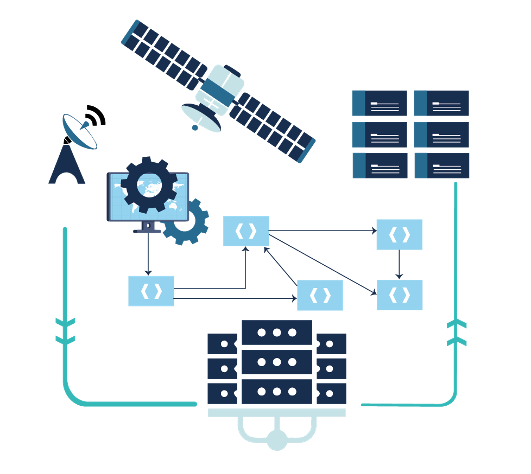
Alimenté par les données produites par les grands instruments (télescopes, satellites, etc.) et l’intelligence artificielle, le paysage scientifique numérique subit une profonde transformation, alimentée par les progrès rapides des capacités de calcul, de stockage et de communication. Le potentiel scientifique de cette révolution intrinsèquement multidisciplinaire réside dans la mise en œuvre de chaînes de calcul et de traitement hybrides, intégrant de plus en plus les infrastructures HPC, les centres de données et les grands instruments.
Anticipant l’arrivée de la machine exascale Alice Recoque, les partenaires et collaborateurs de NumPEx (SKA-France, MesoCloud, PEPR NumPEx, Data Terra, Climeri, TGCC, Idris, Genci) ont décidé de coordonner leurs efforts pour proposer des solutions d’interopérabilité permettant de déployer des chaînes de traitement exploitant pleinement l’ensemble des infrastructures de recherche.
L’objectif de ce travail est de définir une stratégie ouverte pour la mise en œuvre de solutions d’interopérabilité, en conjonction avec de grands instruments scientifiques, afin de faciliter l’analyse des données et d’améliorer la reproductibilité des résultats.
Figure : Vue d’ensemble d’Impact-HPC.
PEPR NumPEx

Impacts-HPC : une bibliothèque Python pour mesurer et comprendre l'empreinte environnementale du calcul scientifique
L’empreinte environnementale du calcul scientifique va bien au-delà de la consommation d’électricité. Impacts-HPC présente un cadre complet pour évaluer les impacts du HPC sur l’ensemble de son cycle de vie, de la fabrication des équipements à la consommation d’énergie, au moyen d’indicateurs environnementaux clés.
L’empreinte écologique du calcul scientifique est souvent réduite à la consommation d’électricité pendant l’exécution. Cependant, cela ne reflète qu’une partie du problème. Impacts-HPC vise à dépasser cette vision limitée en intégrant également l’impact de la fabrication des équipements et en élargissant le spectre des indicateurs pris en compte.
Cet outil permet également de retracer les étapes d’un workflow informatique et de documenter les sources utilisées, améliorant ainsi la transparence et la reproductibilité. Dans un contexte où la crise environnementale nous oblige à considérer simultanément le climat, les ressources et les autres frontières planétaires, de tels outils deviennent indispensables.
La bibliothèque Impacts-HPC couvre plusieurs étapes du cycle de vie : la fabrication et l’utilisation des équipements. Elle met à la disposition des utilisateurs trois indicateurs essentiels :
– Énergie primaire (MJ) : plus pertinente que l’électricité seule, car elle inclut les pertes de conversion tout au long de la chaîne énergétique.
– Impact sur le climat (gCO₂eq): calculé en agrégeant et en convertissant différents gaz à effet de serre en équivalents CO₂.
– Épuisement des ressources (g Sb eq): reflète l’utilisation de ressources non renouvelables, en particulier les minéraux métalliques et non métalliques.
C’est la première fois qu’un tel outil est proposé pour une utilisation directe par les communautés de calcul scientifique, avec une approche intégrée et documentée.
Cette bibliothèque ouvre la voie à une évaluation plus détaillée des impacts environnementaux associés au calcul scientifique. Les prochaines étapes consistent à l’intégrer dans des environnements de jumeaux numériques, à ajouter des données en temps réel (mix énergétique, stockage, transferts) et à la tester sur un centre HPC de référence (IDRIS).
Figure : Vue d’ensemble d’Impact-HPC.
PEPR NumPEx
Stockage de quantités massives de données : mieux comprendre pour mieux concevoir et optimiser
Il est essentiel de comprendre comment les applications scientifiques lisent et écrivent les données pour concevoir des systèmes de stockage qui répondent réellement aux besoins du calcul intensif. La caractérisation fine des E/S permet d’orienter les stratégies d’optimisation et l’architecture des futures infrastructures de stockage.
Les données sont au cœur des applications scientifiques, qu’il s’agisse de données d’entrée ou de résultats de traitement. Depuis plusieurs années, la gestion des données (lecture et écriture, également appelées E/S) constitue un obstacle au déploiement à grande échelle de ces applications. Afin de concevoir des systèmes de stockage plus performants, capables d’absorber et d’optimiser ces E/S, il est essentiel de comprendre comment les applications lisent et écrivent les données.
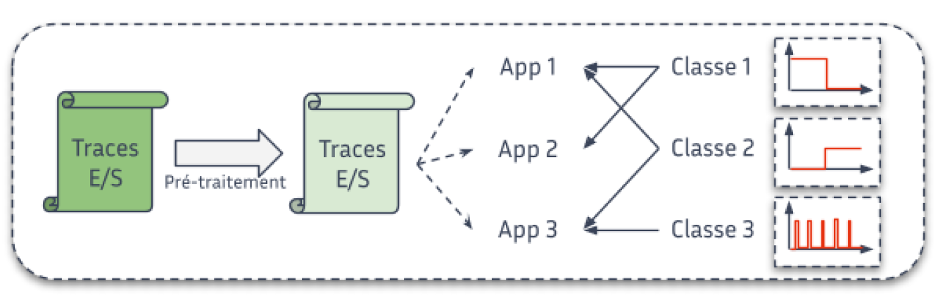
Grâce aux différents outils et méthodes que nous avons développés, nous sommes en mesure de produire une caractérisation détaillée du comportement E/S des applications scientifiques. Par exemple, sur la base des données d’exécution des superordinateurs, nous pouvons montrer que moins d’un quart des applications effectuent des accès réguliers (périodiques), ou que les accès concurrents au système de stockage principal sont moins fréquents que prévu.
Ce type de résultat est déterminant à plusieurs égards. Il permet par exemple de proposer des méthodes d’optimisation des entrées-sorties qui répondent à des comportements applicatifs clairement identifiés. Cette caractérisation est également un élément concret qui influence les choix de conception des futurs systèmes de stockage, toujours dans le but de répondre aux besoins des applications scientifiques.
Figure : Étape de la classification des données.
PEPR NumPEx

Une nouvelle génération de bibliothèques d'algèbre linéaire pour les superordinateurs modernes
Les bibliothèques d’algèbre linéaire sont au cœur du calcul scientifique et de l’intelligence artificielle. En repensant leur exécution sur des architectures hybrides CPU/GPU, de nouveaux modèles basés sur des tâches permettent des gains significatifs en termes de performance, de portabilité et d’utilisation des ressources.
Les bibliothèques de résolution ou de manipulation de systèmes linéaires sont utilisées dans de nombreux domaines de la simulation numérique (aéronautique, énergie, matériaux) et de l’intelligence artificielle (apprentissage). Nous cherchons à rendre ces bibliothèques aussi rapides que possible sur des supercalculateurs combinant des processeurs traditionnels et des accélérateurs graphiques (GPU). Pour ce faire, nous utilisons des modèles d’exécution asynchrones basés sur des tâches qui maximisent l’utilisation des unités de calcul.
Il s’agit d’un domaine de recherche actif, mais la plupart des approches existantes sont confrontées au problème difficile de la division du travail dans la « bonne granularité » pour les unités de calcul hétérogènes. Au cours des derniers mois, nous avons développé plusieurs extensions à un modèle de programmation parallèle basé sur les tâches, appelé STF (Sequential Task Flow), qui permet de mettre en œuvre des algorithmes complexes d’une manière beaucoup plus élégante, concise et portable. En combinant ce modèle avec des techniques de partitionnement dynamique et récursif du travail, nous augmentons significativement les performances sur les supercalculateurs équipés d’accélérateurs tels que les GPU, notamment grâce à la possibilité d’adapter dynamiquement la granularité des calculs en fonction de l’occupation des unités de calcul. Par exemple, grâce à cette approche, nous avons obtenu une accélération de 2x par rapport à d’autres bibliothèques de pointe (MAGMA, Parsec) sur un ordinateur hybride CPU/GPU.
Les opérations d’algèbre linéaire sont souvent les étapes les plus coûteuses dans de nombreuses applications de calcul scientifique, d’analyse de données et d’apprentissage profond. Par conséquent, toute amélioration des performances des bibliothèques d’algèbre linéaire peut potentiellement avoir un impact significatif pour de nombreux utilisateurs de ressources informatiques à haute performance.
Les extensions proposées au modèle STF sont génériques et peuvent également bénéficier à de nombreux codes de calcul au-delà du champ d’application de l’algèbre linéaire.
Au cours de la prochaine période, nous souhaitons étudier l’application de cette approche aux algorithmes d’algèbre linéaire pour les matrices peu denses ainsi qu’aux algorithmes d’algèbre multi-linéaire (calculs tensoriels).
L’adaptation de la granularité permet d’assigner les petites tâches aux CPU, qui ne les occuperont pas trop longtemps, évitant ainsi des retards pour le reste de la machine, tout en continuant d’assigner les grandes tâches aux GPU afin qu’ils restent efficaces.
Figure : L’ajustement de la taille du grain permet d’assigner des tâches plus petites aux CPU, qui ne prendront pas trop de leur temps, évitant ainsi des retards pour le reste de la machine, tout en continuant d’assigner des tâches plus importantes aux GPU afin qu’ils restent efficaces.
PEPR NumPEx
Du dépôt Git à l'exécution en masse : Exa-MA industrialise le déploiement d'applications HPC conformes à NumPEx
En unifiant les flux de travail et en automatisant les étapes clés du cycle de vie des logiciels HPC, le cadre Exa-MA contribue à un déploiement plus fiable, portable et efficace des applications sur les systèmes nationaux et EuroHPC.
Les applications HPC nécessitent reproductibilité, portabilité et tests à grande échelle, mais le passage du code à l’ordinateur reste long et hétérogène selon les sites. L’objectif est d’unifier le cadre applicatif Exa-MA et d’automatiser les constructions, les tests et les déploiements conformément aux directives NumPEx.
Un cadre d’application Exa-MA a été mis en place, intégrant la gestion des modèles, des métadonnées et des procédures de vérification et de validation (V&V). Parallèlement, une chaîne complète de CI/CD HPC a été déployée, combinant Spack, Apptainer/Singularity et la soumission automatisée via ReFrame/SLURM orchestrée par GitHub Actions. Cette infrastructure fonctionne de manière transparente sur les ordinateurs nationaux français et les plateformes EuroHPC, avec une automatisation de bout en bout des étapes critiques.
Dans les premiers cas d’utilisation, le délai entre la validation du code et l’exécution à grande échelle a été réduit de plusieurs jours à moins de 24 heures, sans aucune intervention manuelle sur le site. Les performances sont désormais contrôlées par des tests de non-régression (évolutivité élevée/faible) et seront bientôt améliorées par des artefacts de profilage.
L’approche déployée révolutionne l’intégration des applications Exa-MA, accélère l’onboarding et assure une qualité contrôlée grâce à des tests automatisés et une traçabilité complète.
La prochaine phase du projet consiste à mettre en ligne les applications Exa-MA et à déployer un tableau de bord des performances.
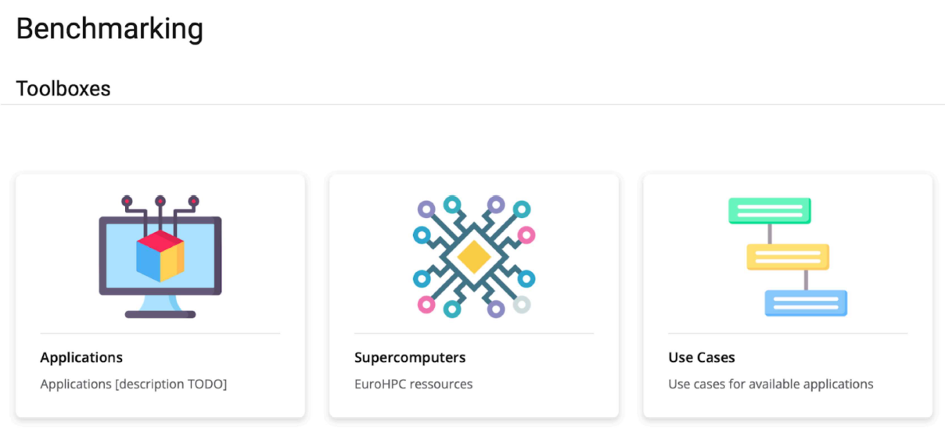
Figure : Analyse comparative des pages d’un site web avec des vues par application, par machine et par cas d’utilisation.
PEPR NumPEx