

Le troisième atelier de co-conception et de co-développement d'Exa-DI sur "l'intelligence artificielle pour HPC@Exscale".
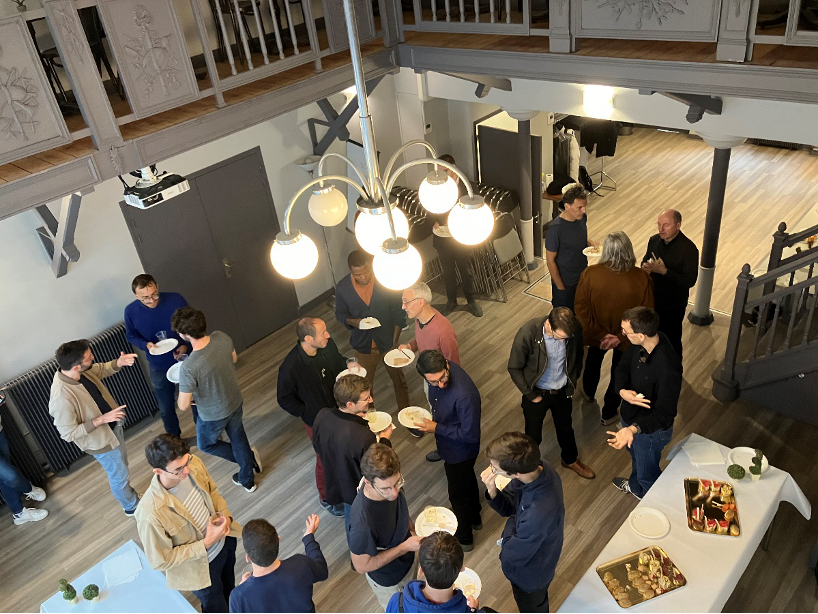
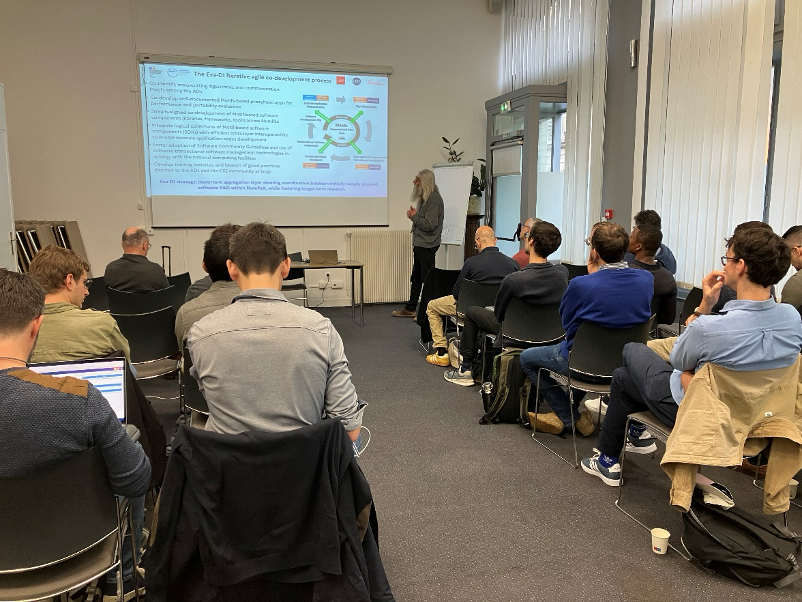
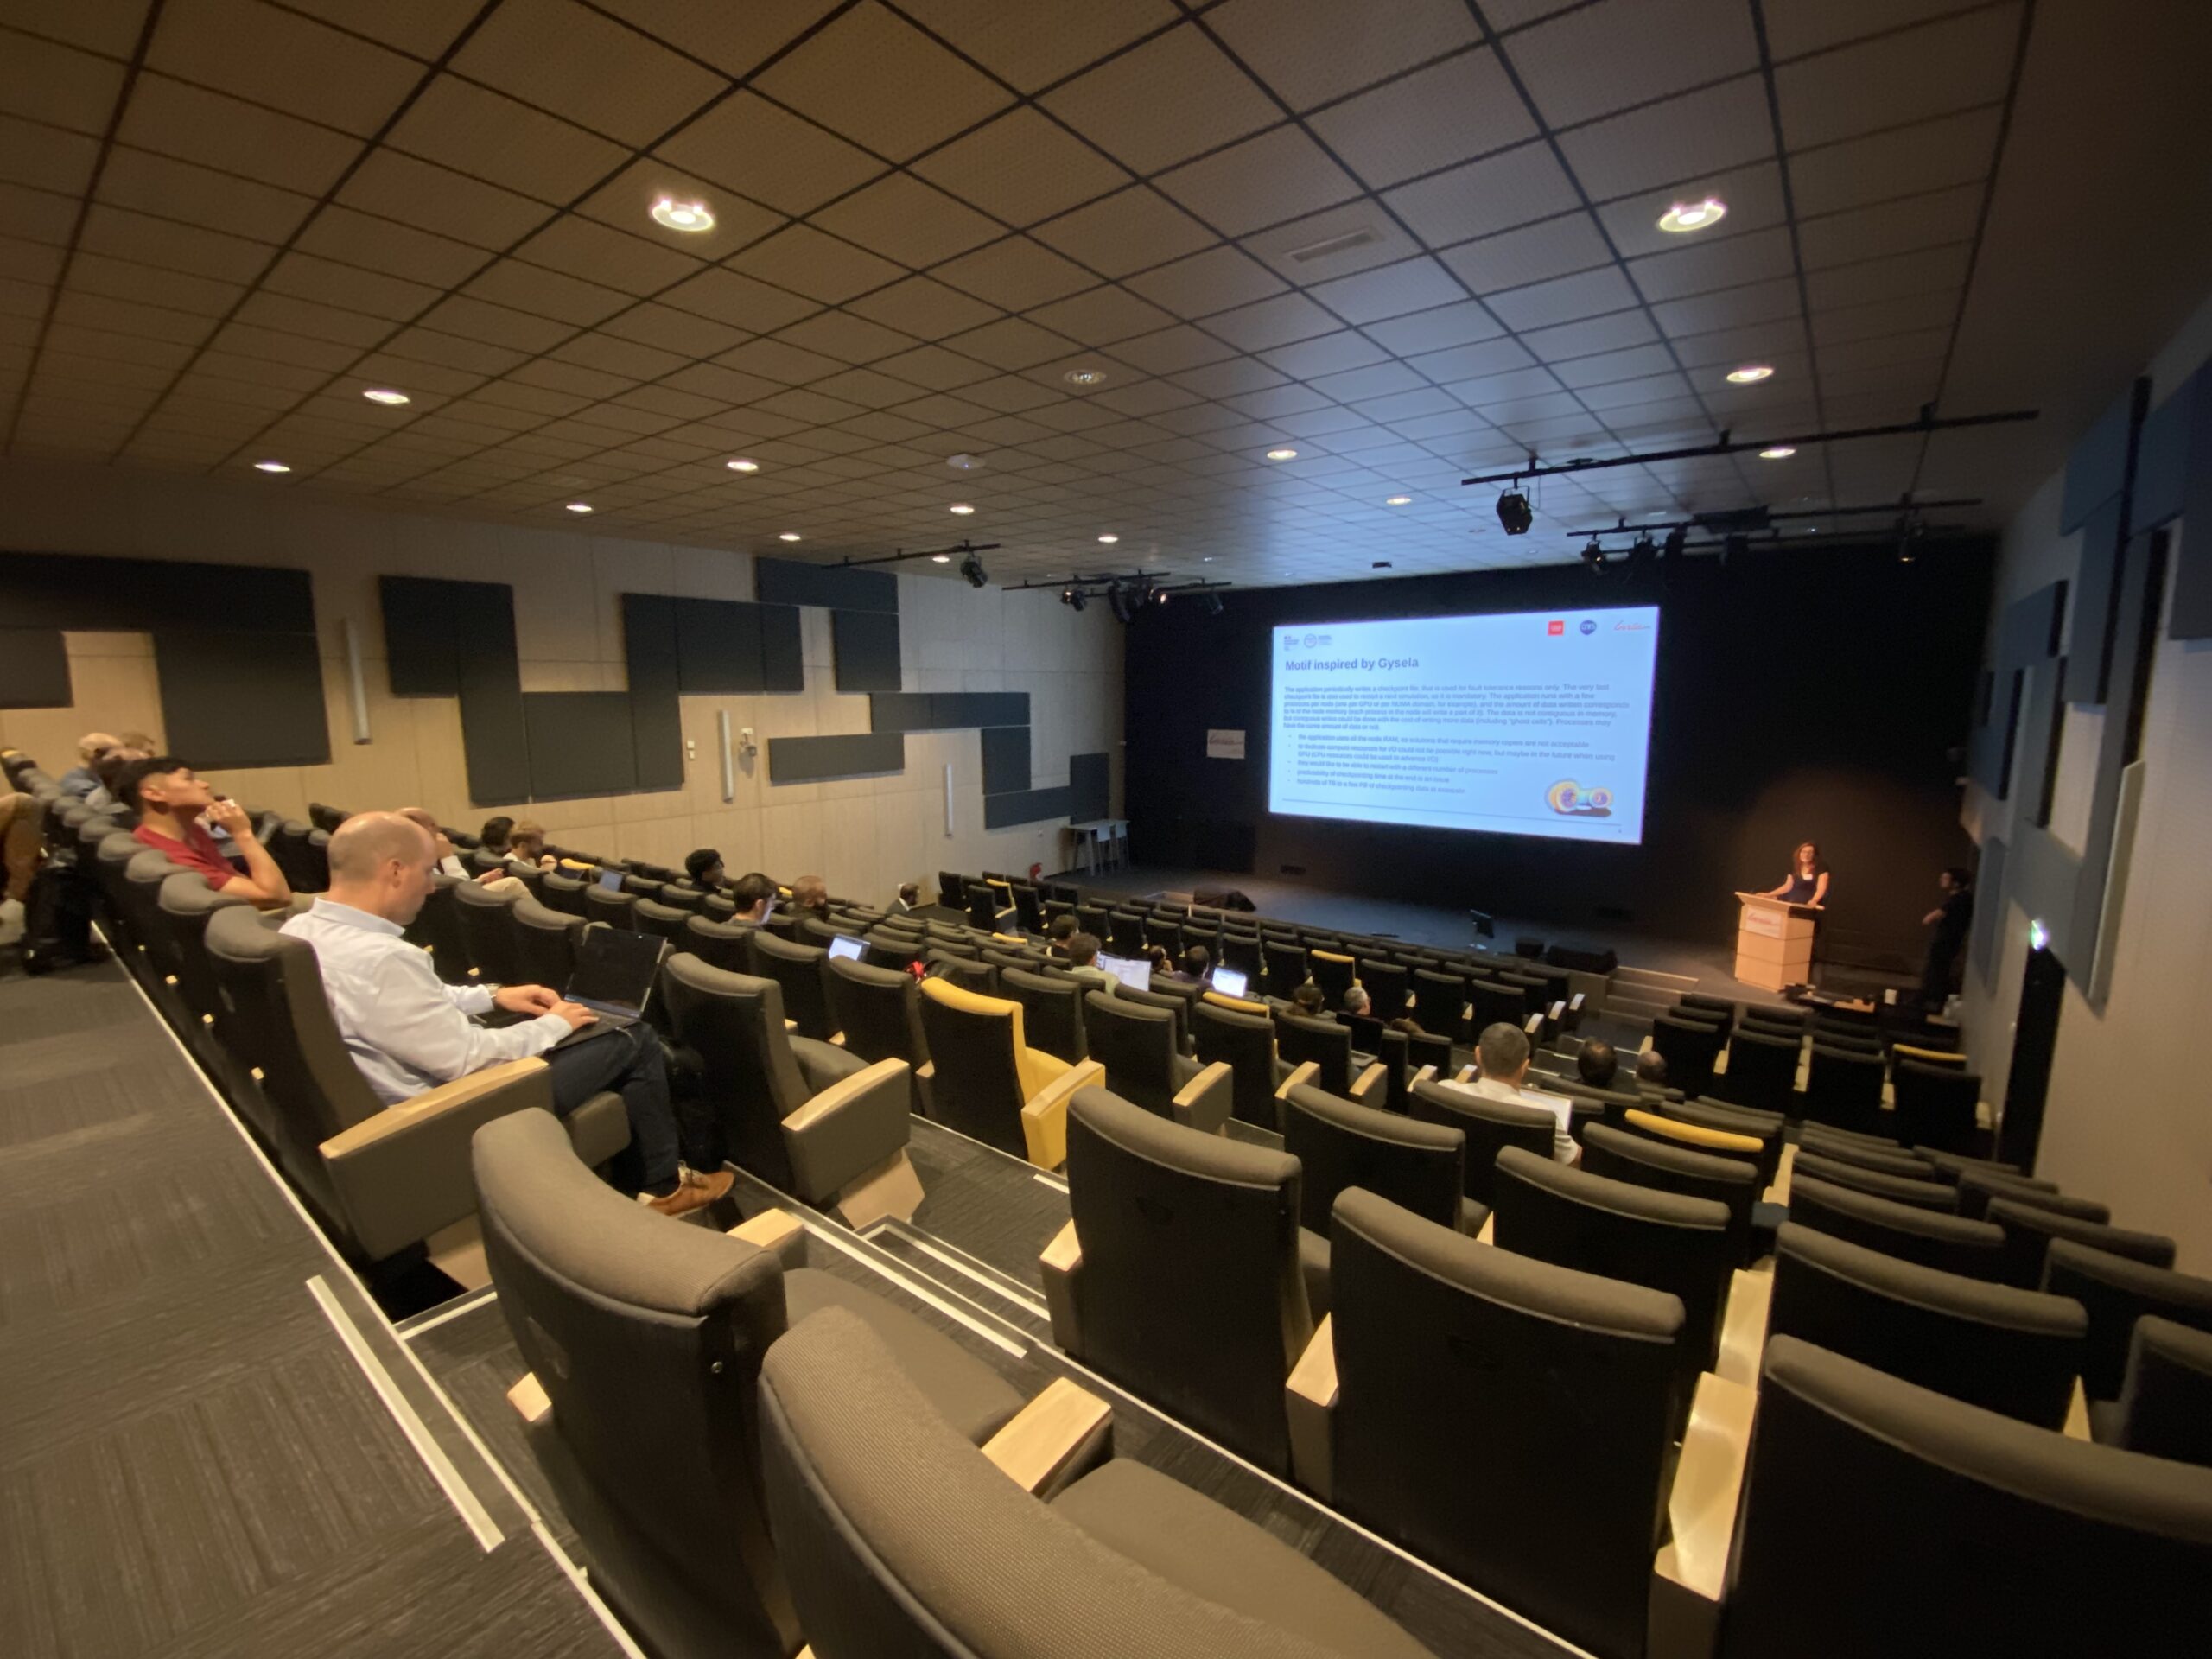
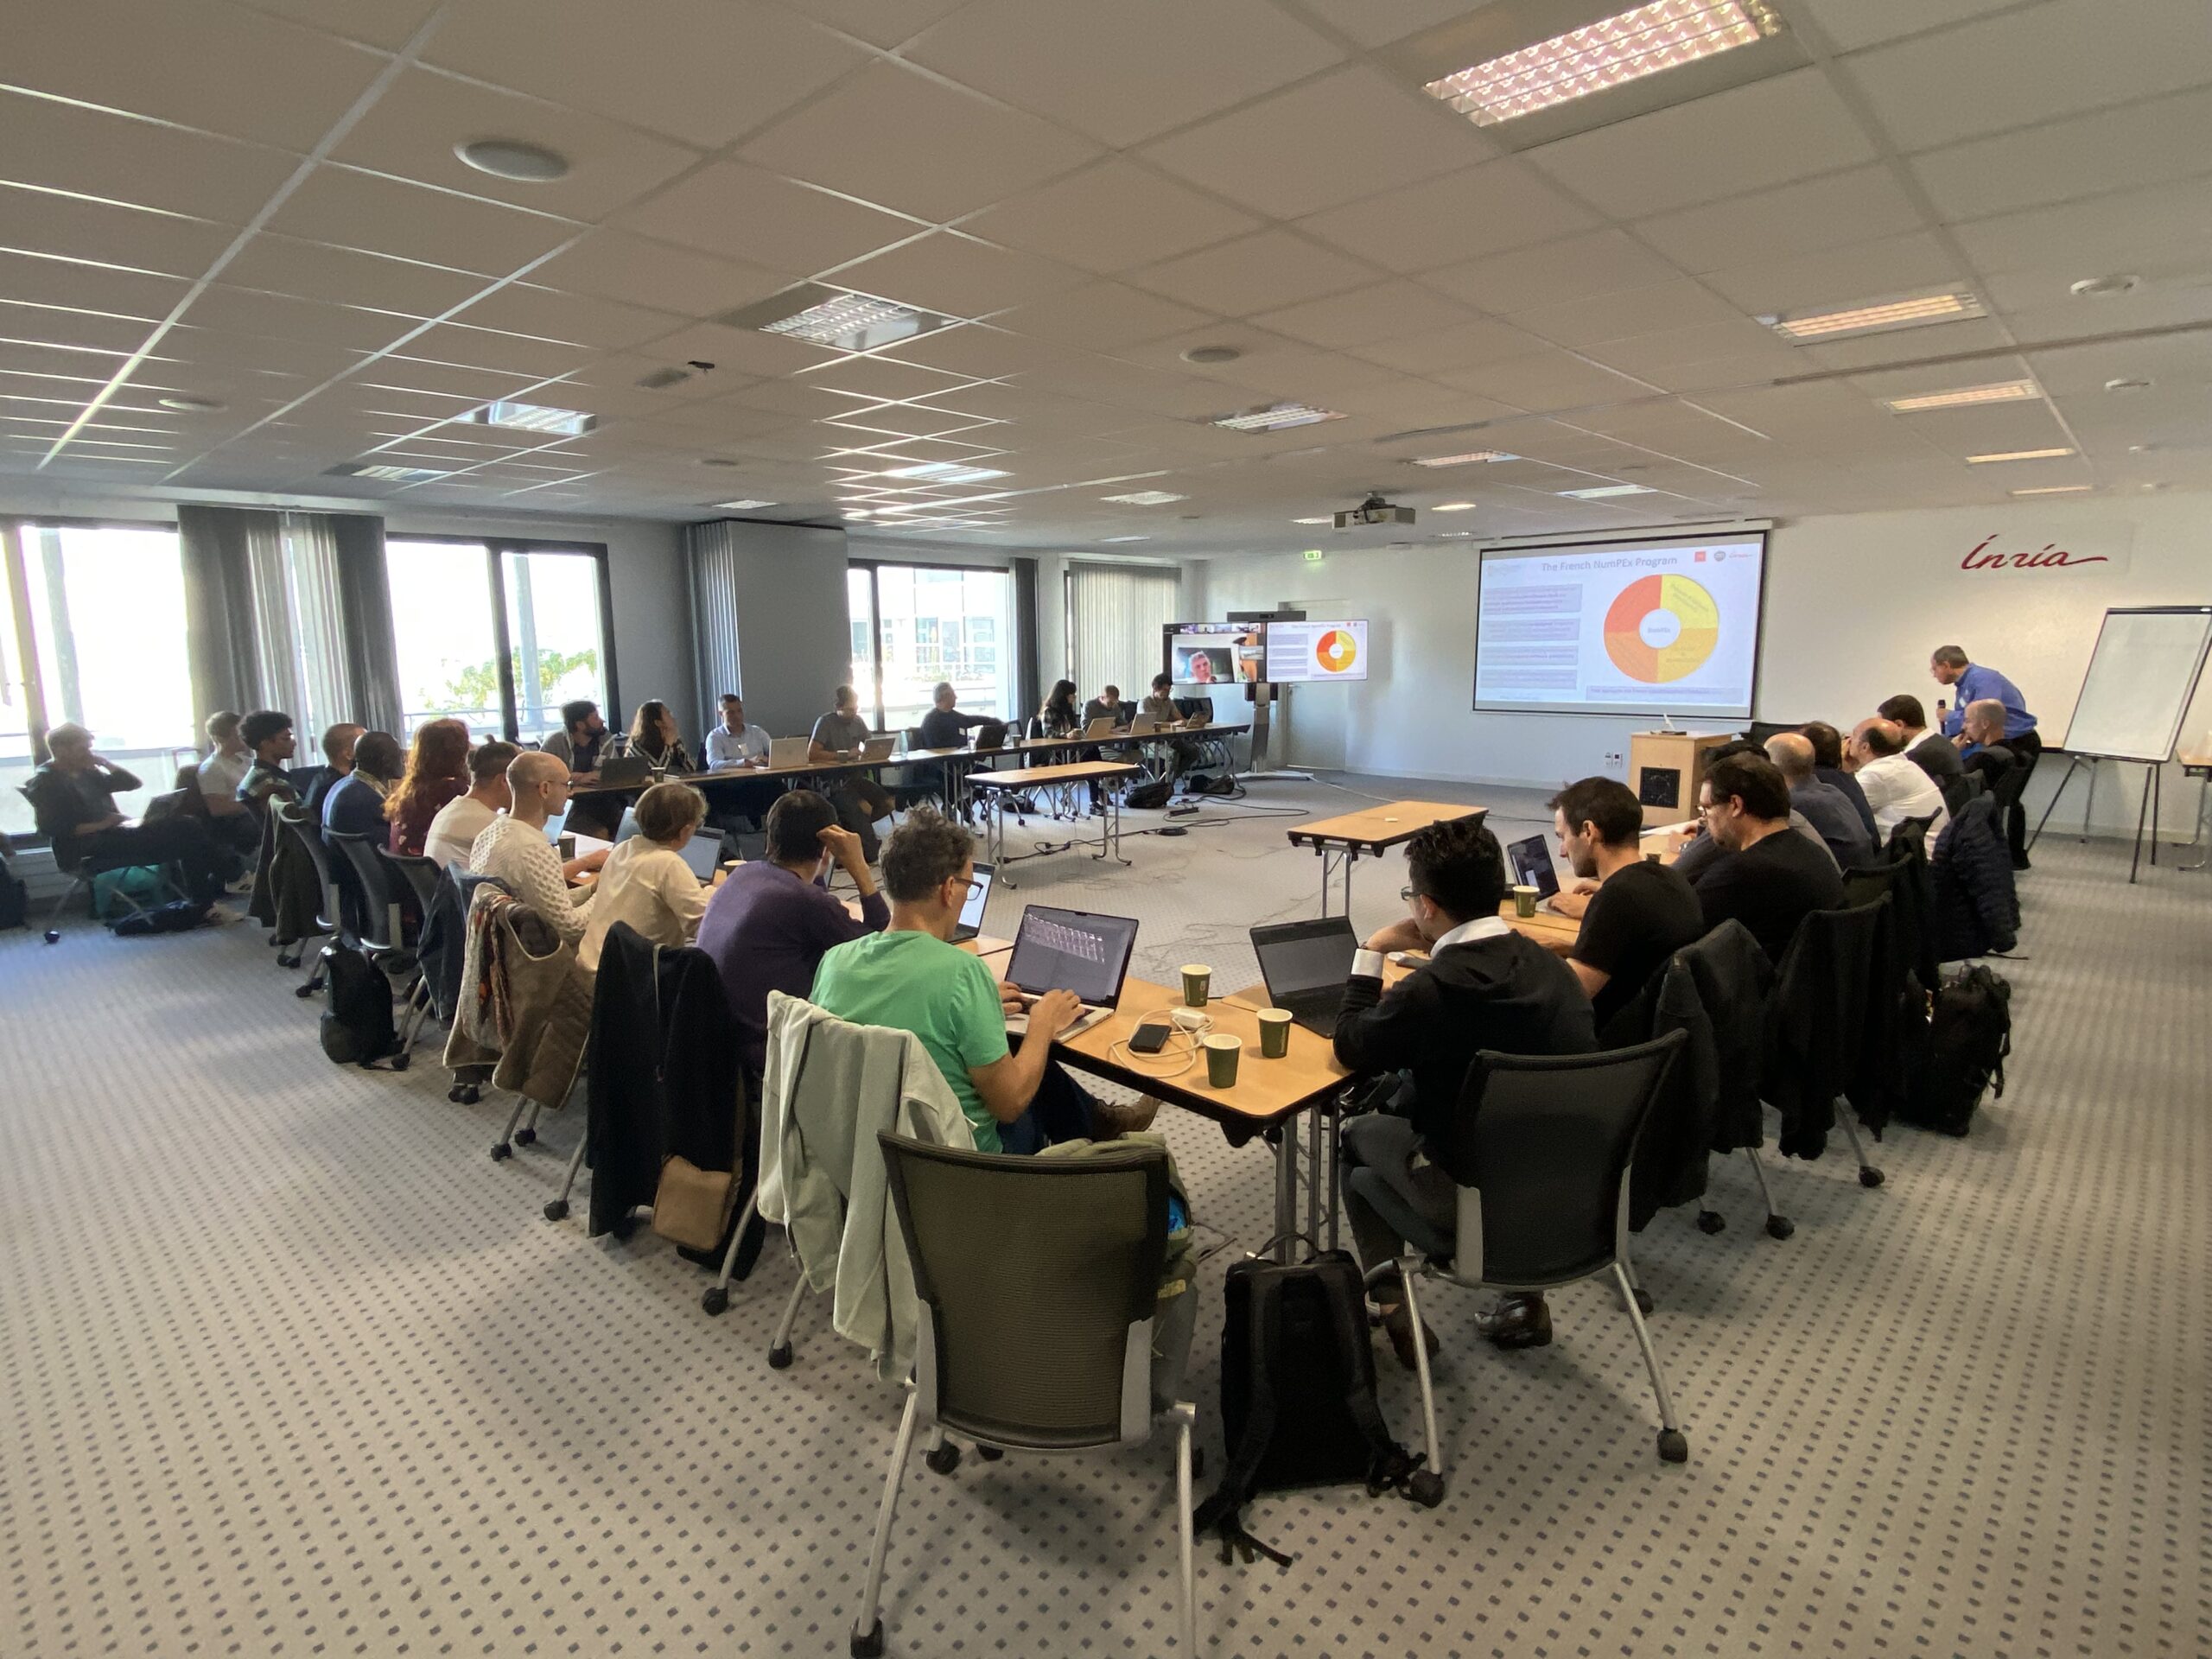
Le troisième atelier de co-conception/co-développement du projet Exa-DI (Développement et Intégration) du PEPR NumPEx était dédié à « l’Intelligence Artificielle pour HPC@Exscale » en ciblant les deux sujets « Image analysis @ exascale » et « Data analysis and robust inference @ exascale ». Il s’est déroulé les 2 et 3 octobre 2024 à l’Espace La Bruyère, Du Côté de la Trinité (DCT) à Paris.
Cet atelier en présentiel a réuni, pendant deux jours, des membres d’Exa-DI ainsi que des membres des autres projets NumPEx (Exa-MA : Méthodes et algorithmes pour l’exascale, Exa-SofT : Logiciels et outils HPC, Exa-DoST : Logiciels et outils orientés données pour l’exascale et Exa-AToW : Architectures et outils pour les flux de travail à grande échelle), des démonstrateurs d’applications (AD) issus de divers secteurs de la recherche et de l’industrie, ainsi que des experts, afin de discuter des avancées et des orientations futures concernant l’intégration de l’intelligence artificielle dans les flux de travail HPC/HPDA à l’exascale, en se concentrant sur les deux thèmes suivants : « Analyse d’images volumineuses » et « Analyse de données et inférence robuste ».
Cet atelier est le troisième d’une série consacrée à la conception et au développement conjoints, dont l’objectif principal est de promouvoir des stratégies de développement conjoint de piles logicielles afin d’accélérer le développement à l’exascale et d’améliorer la portabilité des performances des applications en sciences et ingénierie computationnelles. Cet atelier se distingue quelque peu des deux précédents en ce qu’il revêt un caractère prospectif, axé sur l’importance croissante des flux de travail HPC/HPDA pilotés par l’IA et couplés à l’IA, qui évoluent rapidement, dans les domaines de « l’analyse d’images volumineuses à l’exascale » et de « l’analyse de données (simulation, expériences, observation) et l’inférence robuste à l’exascale ». Ses principaux objectifs sont, d’une part, de parvenir à une compréhension commune des différents modes de couplage de l’IA dans les flux de travail HPC/HPDA et, d’autre part, d’identifier conjointement les motifs d’exécution les plus couramment rencontrés dans les applications scientifiques afin de favoriser le co-développement de benchmarks collaboratifs spécifiques ou d’applications de substitution permettant d’évaluer/mesurer les performances de bout en bout des flux de travail HPC/HPDA couplés à l’IA et, enfin, d’identifier conjointement les composants logiciels (bibliothèques, frameworks, communication de données, outils de flux de travail, couches d’abstraction, environnements de programmation et d’exécution) à développer et à intégrer conjointement afin d’améliorer les composants critiques et d’accélérer leur exécution.
Principales sessions
- Introduction et contexte: présenter les deux thèmes principaux de l’atelier et vous présenter l’action transversale GT IA au sein de NumPEx.
- Présentation des participantes et participants: Permettre aux participantes et participants de se présenter et de faire part de leurs intérêts.
- Différentes sessions: Ces sessions ont donné lieu à des exposés sur les défis à relever et les goulots d’étranglement à surmonter (vitesse d’exécution, évolutivité, volume de données…), sur le type, le format et le volume des données actuellement étudiées, sur les frameworks ou les langages de programmation actuellement utilisés (par exemple Python, PyTorch, JAX, C++, etc.) ainsi que sur les opérations élémentaires typiques effectuées sur les données.
- Débats et tables rondes: Ces sessions ont permis aux participants de prendre part à des débats et d’échanger leurs points de vue sur les thèmes abordés, afin de définir une stratégie permettant de relever les défis liés aux processus de co-conception et de co-développement.
Conférencières et conférenciers invités
- Jean-Pierre Vilotte du CNRS, membre d’Exa-DI, qui a présenté le contexte introductif de l’atelier.
- Thomas Moreau de l’Inria, membre d’Exa-DoST, présentant la GT IA, une action transversale dans NumPEx.
- Tobias Liaudat du CEA, sur la quantification rapide et évolutive de l’incertitude pour l’imagerie scientifique.
- Damien Gradatour du CNRS, qui aborde la question de la construction de nouveaux cerveaux pour les télescopes astronomiques géants grâce aux réseaux neuronaux profonds (Deep Neural Networks).
- Antoine Petiteau du CEA, discutant de l’analyse des données pour l’observation de l’Univers avec les ondes gravitationnelles à basse fréquence.
- Kevin Sanchis de Safran AI, sur l’évaluation des méthodes d’apprentissage auto-supervisé dans le domaine de la télédétection.
- Hugo Frezat de l’Université Paris Cité, présentant des modèles d’apprentissage à l’échelle de la maille pour la convection turbulente en rotation.
- Benoit Semelin de la Sorbonne Université, discutant de l’inférence basée sur la simulation avec des simulations d’hydrodynamique radiative cosmologique pour le SKA.
- Bruno Raffin & Thomas Moreau de l’Inria, présentant l’analyse basée sur l’apprentissage automatique de grands résultats de simulation dans Exa-DoST.
- Julián Tachella du CNRS, présentant DeepInverse : une bibliothèque PyTorch pour résoudre des problèmes inverses avec l’apprentissage profond.
- Erwan Allys de l’ENS-PSL, explorant le modèle génératif et la séparation des composants dans un régime de données limitées avec la Transformée de diffusion.
- François Lanusse du CNRS, discutant du pré-entraînement multimodal pour les données scientifiques : Vers des modèles de grandes données pour l’astrophysique. > en ligne
- Christophe Kervazo de Telecom Paris, abordant les méthodes d’apprentissage profond interprétables et évolutives pour les problèmes inverses d’imagerie.
- Eric Anterrieu du CNRS, explorant l’approche basée sur l’apprentissage profond en radiométrie d’imagerie par synthèse d’ouverture et son implémentation.
- Philippe Ciuciu du CEA, sur l’IRM computationnelle à l’ère de l’apprentissage profond.
- Pascal Tremblin du CEA, caractérisant les modèles dans les simulations HPC à l’aide de la reconnaissance d’images et de la catégorisation pilotées par l’IA.
- Bruno Raffin de l’Inria, membre d’Exa-DI, présentant le Software Packaging dans Exa-DI
Conclusion et impacts
De nombreuses discussions intéressantes et fructueuses ont eu lieu au cours de cet atelier prospectif. Ces discussions nous ont tout d’abord permis de mieux cerner les défis et les goulots d’étranglement qui sous-tendent les flux de travail HPC/HPDA basés sur l’IA les plus couramment rencontrés dans les départements de recherche. Ensuite, une première série de problèmes connexes à traiter a été identifiée ; ces problèmes peuvent être regroupés en deux axes principaux : (i) le traitement d’images en grands volumes, issues soit de simulations, soit d’expériences, et (ii) l’exploration d’espaces de paramètres à haute dimension et multimodaux.
L’une des questions très intéressantes qui est ressortie de ces discussions concerne la pile logicielle NumPEx et, en particulier, la manière dont celle-ci pourrait être étendue au-delà de la prise en charge des bibliothèques classiques d’IA/ML (par exemple, TensorFlow, PyTorch) pour permettre l’exécution couplée, simultanée et en temps réel de workflows d’IA et de HPC/HPDA, de manière à ce que les systèmes d’IA puissent orienter ou alimenter les tâches HPC/HPDA, et inversement ?
Un premier défi réside dans la coexistence et la communication entre les tâches HPC/HPDA et celles liées à l’IA au sein d’un même flux de travail. Cette communication est principalement entravée par la différence entre les modèles de programmation utilisés en HPC (à savoir C++, C ; et Fortran) et celles de l’IA (à savoir Python), ce qui nécessite une gestion plus unifiée du plan de données, permettant d’exposer des abstractions de données de haut niveau et de masquer, tant aux simulations HPC qu’aux modèles d’IA, les complexités liées à la conversion de format, au stockage et au transport des données. Un deuxième défi concerne l’utilisation des informations fournies par les modèles d’IA et les simulations pour identifier les motifs d’exécution couramment observés dans les AD, afin de guider, d’orienter ou de modifier la structure du flux de travail en déclenchant ou en arrêtant de nouvelles tâches HPC/HPDA. Cela implique que les systèmes de gestion des flux de travail doivent être capables d’intégrer et de réagir de manière dynamique aux entrées provenant des modèles d’IA. Cela devrait favoriser le co-développement de nouvelles bibliothèques, de nouveaux frameworks ou de nouveaux outils de flux de travail prenant en charge l’intégration de l’IA dans les flux de travail HPC/HPDA.
Par ailleurs, ces discussions ont mis en évidence qu’une action importante à mener prochainement consisterait à mettre en place une collaboration interfonctionnelle entre le développement des composants logiciels et des flux de travail, d’une part, et leur intégration aux technologies NumPEx dans leur ensemble, d’autre part, ainsi qu’à rationaliser les flux de travail des développeurs et des utilisateurs.
Il a donc été décidé, au cours de cet atelier, de mettre en place un groupe de travail chargé d’aborder ces différentes questions et permettant, à terme, de développer une suite d’applications proxy et de tests de performance communs et clairement définis, avec des données et des indicateurs de comparaison bien identifiés répondant à ces différents enjeux. Plusieurs équipes composées d’administrateurs de domaine et d’experts ont manifesté leur intérêt pour participer à ce groupe de travail qui sera constitué. Une première réunion rassemblant tous les participants intéressés sera organisée prochainement.
Participantes et participants
- Jean-Pierre Vilotte, chercheur CNRS et membre d’Exa-DI
- Valérie Brenner, chercheuse CEA et membre d’Exa-DI
- Jérôme Bobin, chercheur CEA et membre d’Exa-DI
- Jérôme Charousset, CEA et membre d’Exa-DI
- Mark Asch, enseignant-chercheur à l’Université Picardie et membre d’Exa-DI
- Bruno Raffin, Inria et membre d’Exa-DI et Exa-DoST
- Rémi Baron, CEA et membre d’Exa-DI
- Karim Hasnaoui, chercheur CNRS et membre d’Exa-DI
- Felix Kpadonou, CEA et membre d’Exa-DI
- Thomas Moreau, Inria et membre d’Exa-DoST
- Erwan Allys, ENS-PSL et démonstrateur d’application
- Damien Gradatour, CNRS et démonstrateur d’application
- Antoine Petiteau, CEA et démonstrateur d’application
- Hugo Frezat, Université Paris Cité et démonstrateur d’application
- Alexandre Fournier, Institut de physique du globe et démonstrateur d’application
- Tobias Liaudat, CEA
- Jonathan Kem, CEA
- Kevin Sanchis, Safran AI
- Benoit Semelin, Sorbonne Université
- Julian Tachella, CNRS
- François Lanusse, CNRS
- Christophe Kervazo, Telecom Paris
- Eric Anterrieu, CNRS
- Philippe Ciuiciu, CEA
- Pascal Tremblin, CEA
Valérie Brenner

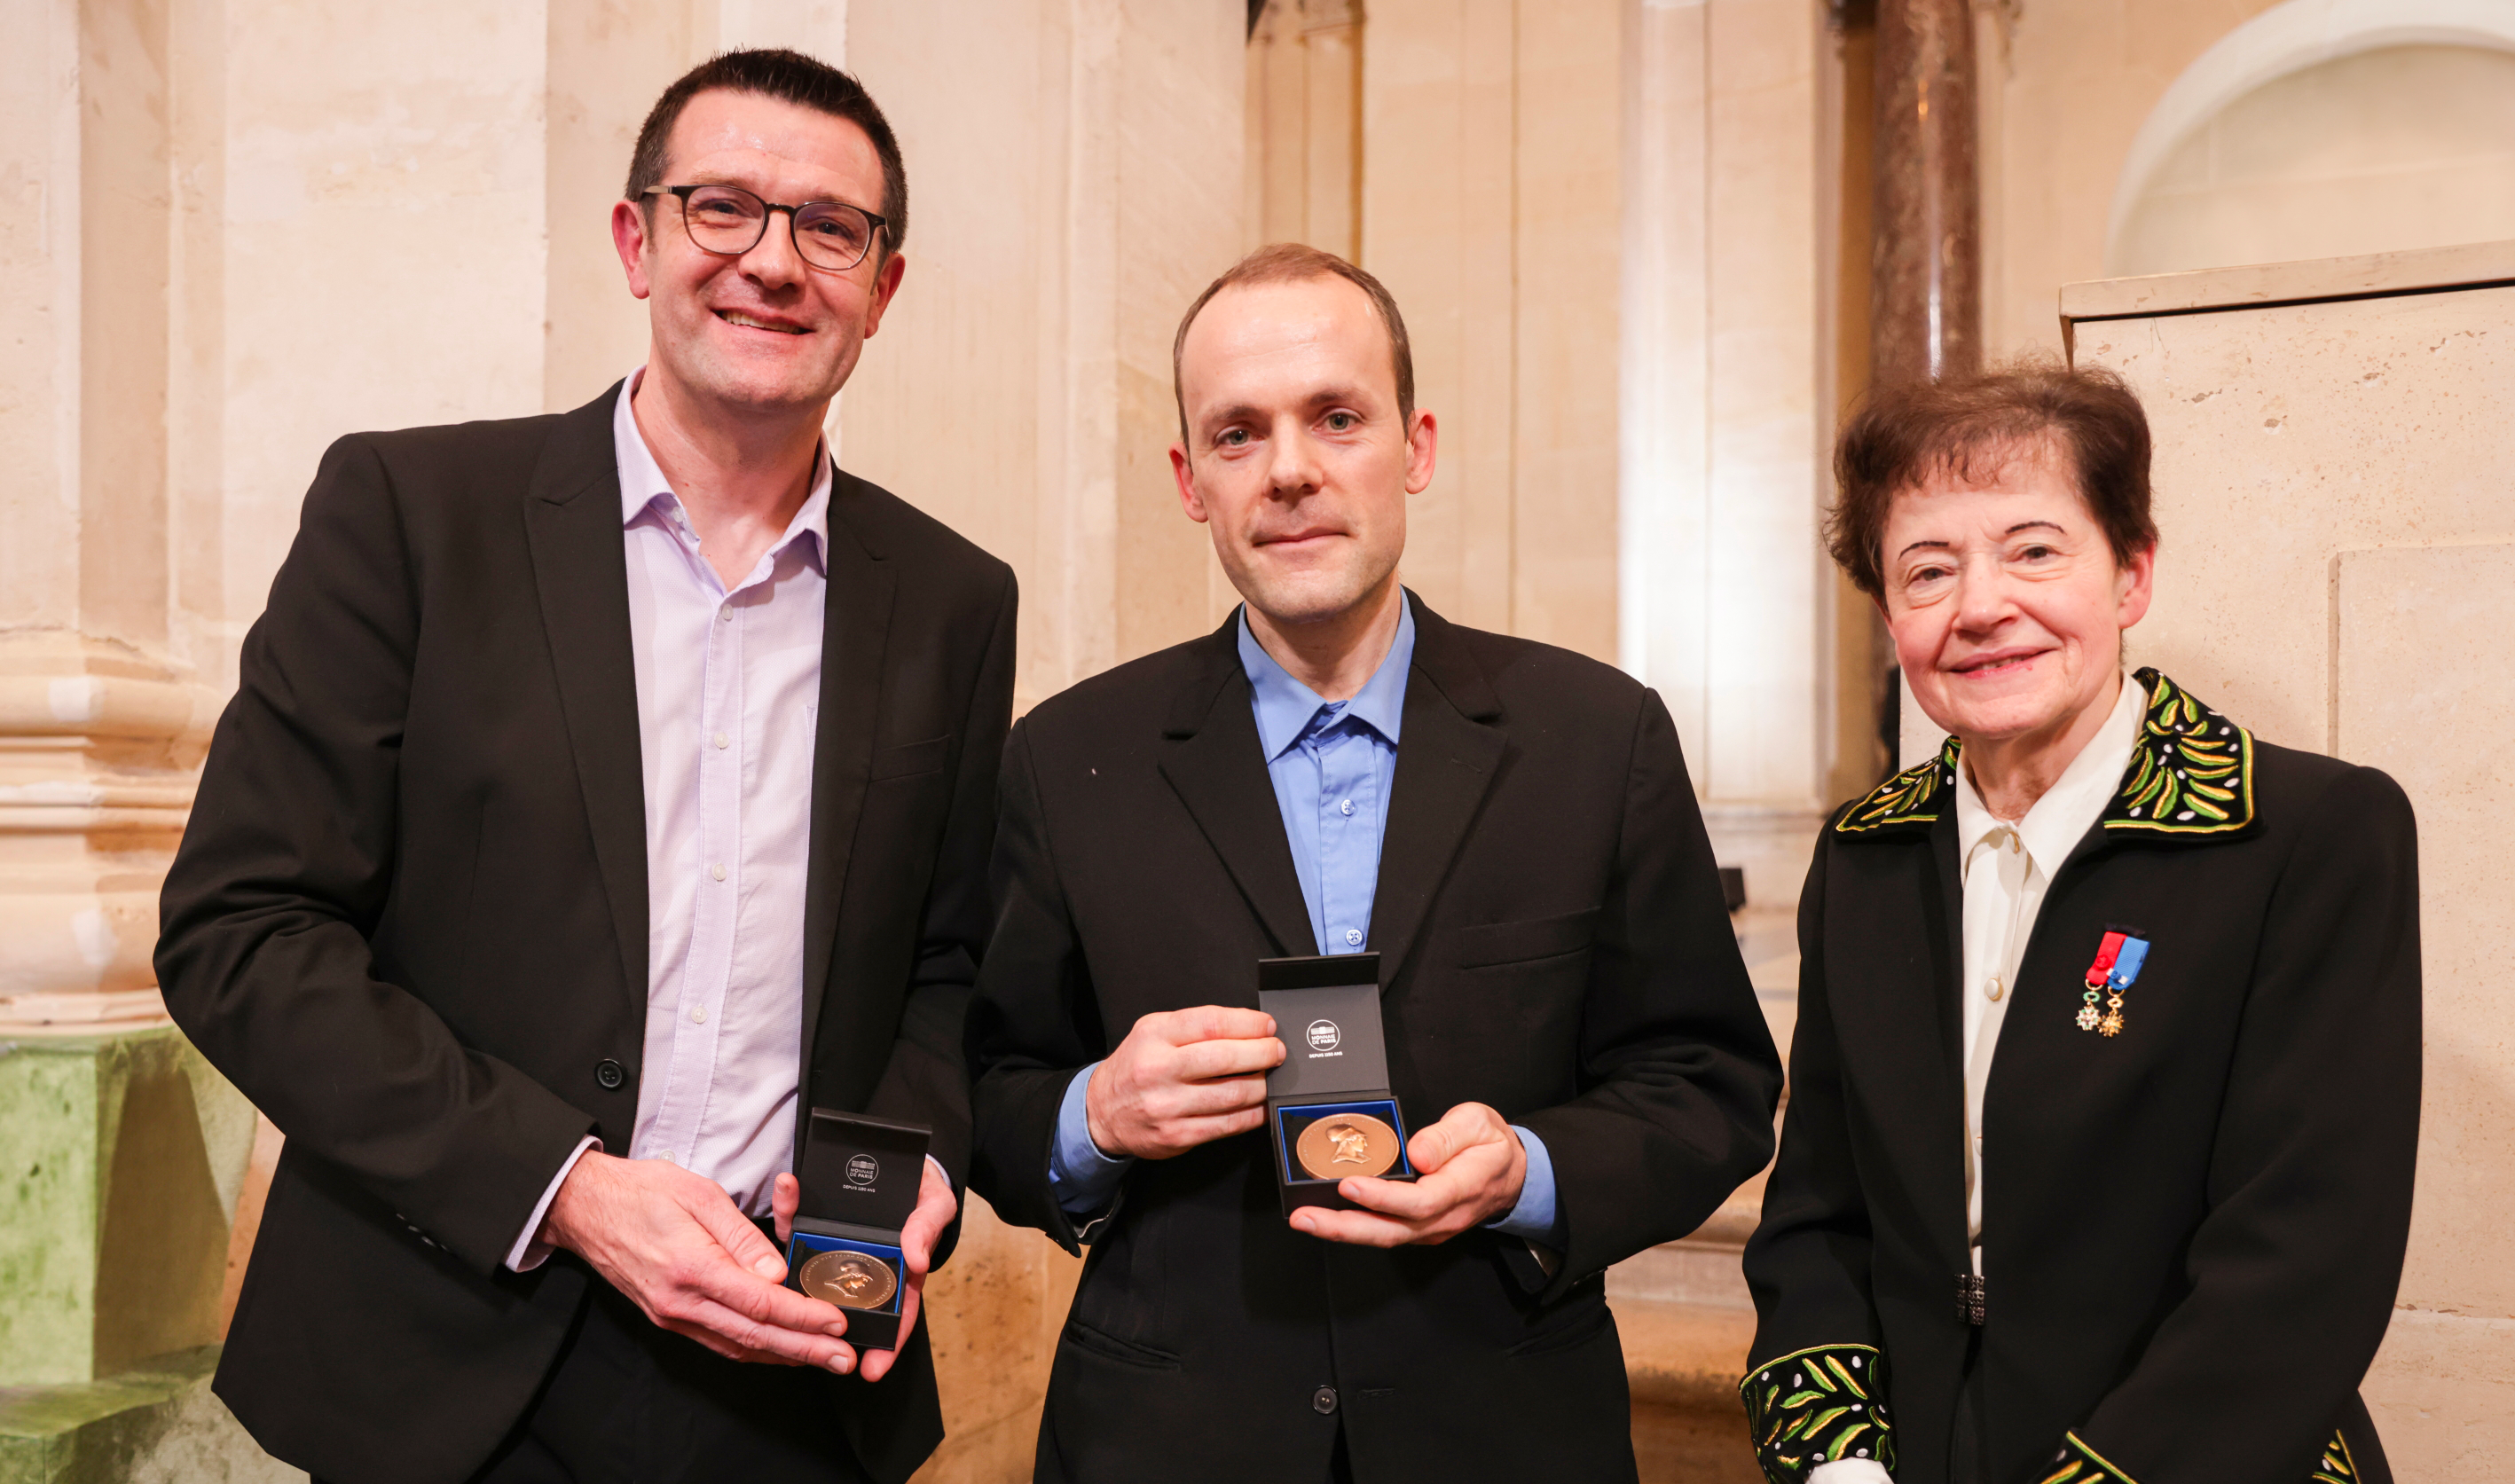
Brice Goglin et Samuel Thibault : experts en cartographie HPC récompensés par l'Académie des sciences
Chaque année, au mois de novembre, l’Académie des sciences dévoile ses prestigieux prix. Cette année, aux côtés de Brice Goglin, le membre du NumPEx Samuel Thibault vient de recevoir le Prix de l’innovation Inria – Académie des sciences – Dassault Systèmes.
Samuel Thibault est responsable de la partie « runtime » de la pile logicielle Exa-SofT. Plus précisément, il est chargé de l’intégration des communications avec l’ordonnancement des tâches, de l’expression de haut niveau de la division des tâches de calcul et de la tolérance aux pannes. Samuel est également co-responsable du groupe de travail Accelerator.
Pour en savoir plus sur ses recherches, consultez l’article publié par Inria.
Crédit photo académie des sciences – Mathieu Baumer
Appel à propositions "Numérique pour l'Exascale" (en anglais)
Le programme NumPEx lance son premier appel à projets destiné à soutenir des avancées dans le domaine du calcul haute performance (HPC), de l’analyse de données haute performance (HPDA) et de l’intelligence artificielle (IA). Ce programme de recherche France 2030 vise à développer des logiciels capables d’exploiter les futures machines exascales et à préparer les principaux codes d’application scientifiques et industriels.
Cet appel s’articule autour de trois axes :
- Méthodes, algorithmes et logiciels émergents en IA pour le calcul scientifique et HPC pour l’IA.
- Modèles de programmation adaptés aux architectures accélérées.
- Workflows pour l’analyse des données scientifiques, avec le projet SKA comme cas d’usage.
Cet appel à projets est doté d’un budget de 4 millions d’euros. Il financera 1 à 2 projets par axe, pour une durée maximale de 48 mois.
Le montant de l’aide demandée devra être d’un montant minimum de 500 k€ et d’un montant maximum de 1 M€ suivant le thème du projet.
Un même responsable du projet ne pourra être porteur que d’un seul projet du PEPR, y compris les projets ciblés.
Date limite de candidature : 14 avril 2025 (11h00 CET).
Josselin Garnier nommé à l'Académie des Sciences de France
Josselin Garnier, professor at École Polytechnique and member of Exa-MA, is one of 18 scientists appointed to the French Académie des sciences in recognition of his significant contributions to research.
Alongside Clément Gauchy, CEA research staff member, Josselin Garnier coordinates the workpackage « Uncertainty quantification » of the Exa-MA project. The objective of this workpackage is to leverage exascale computing to implement advanced analysis methods that require a large number of executions of complex simulation codes to quantify uncertainties in these simulations and solve inverse or optimization problems in the presence of uncertainties. The work carried out aims to quantify the confidence that can be placed in the predictions derived from these simulations and to facilitate decision-making based on them.
Learn more about his career and research in the article published by the French Académie des sciences.
Crédit photo : Adobe Stock
Assemblée générale 2024 d'Exa-DoST
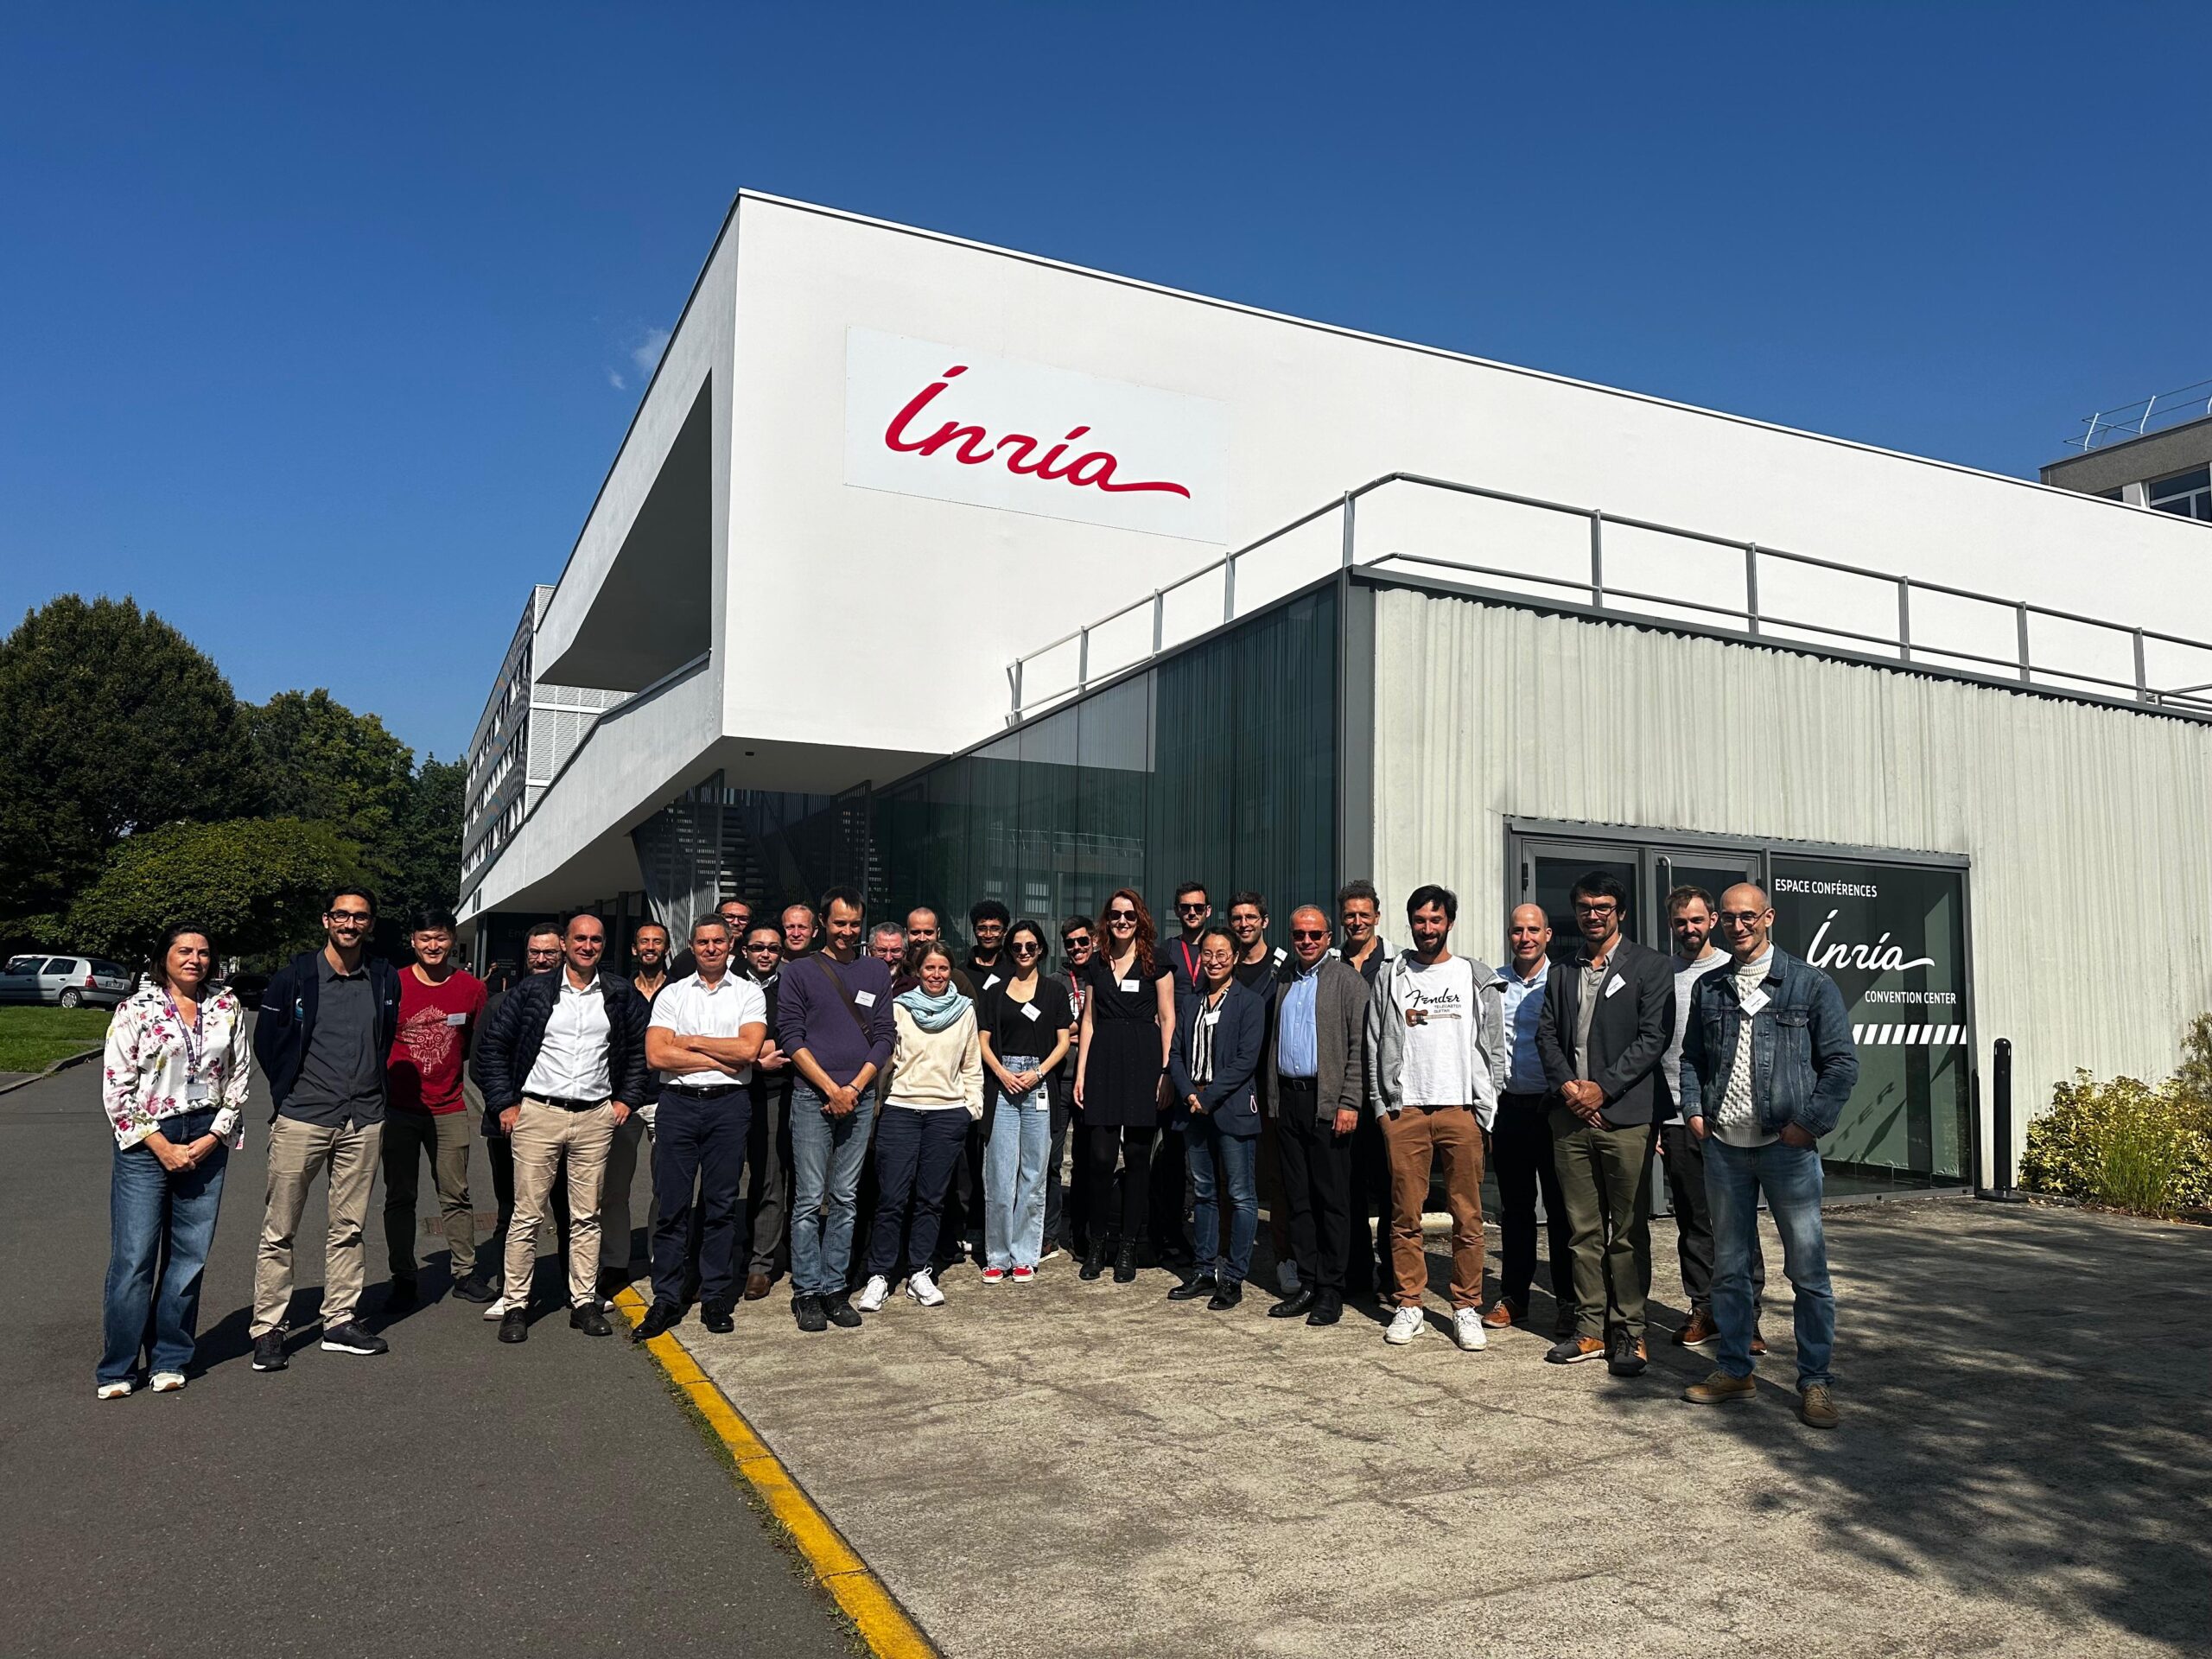
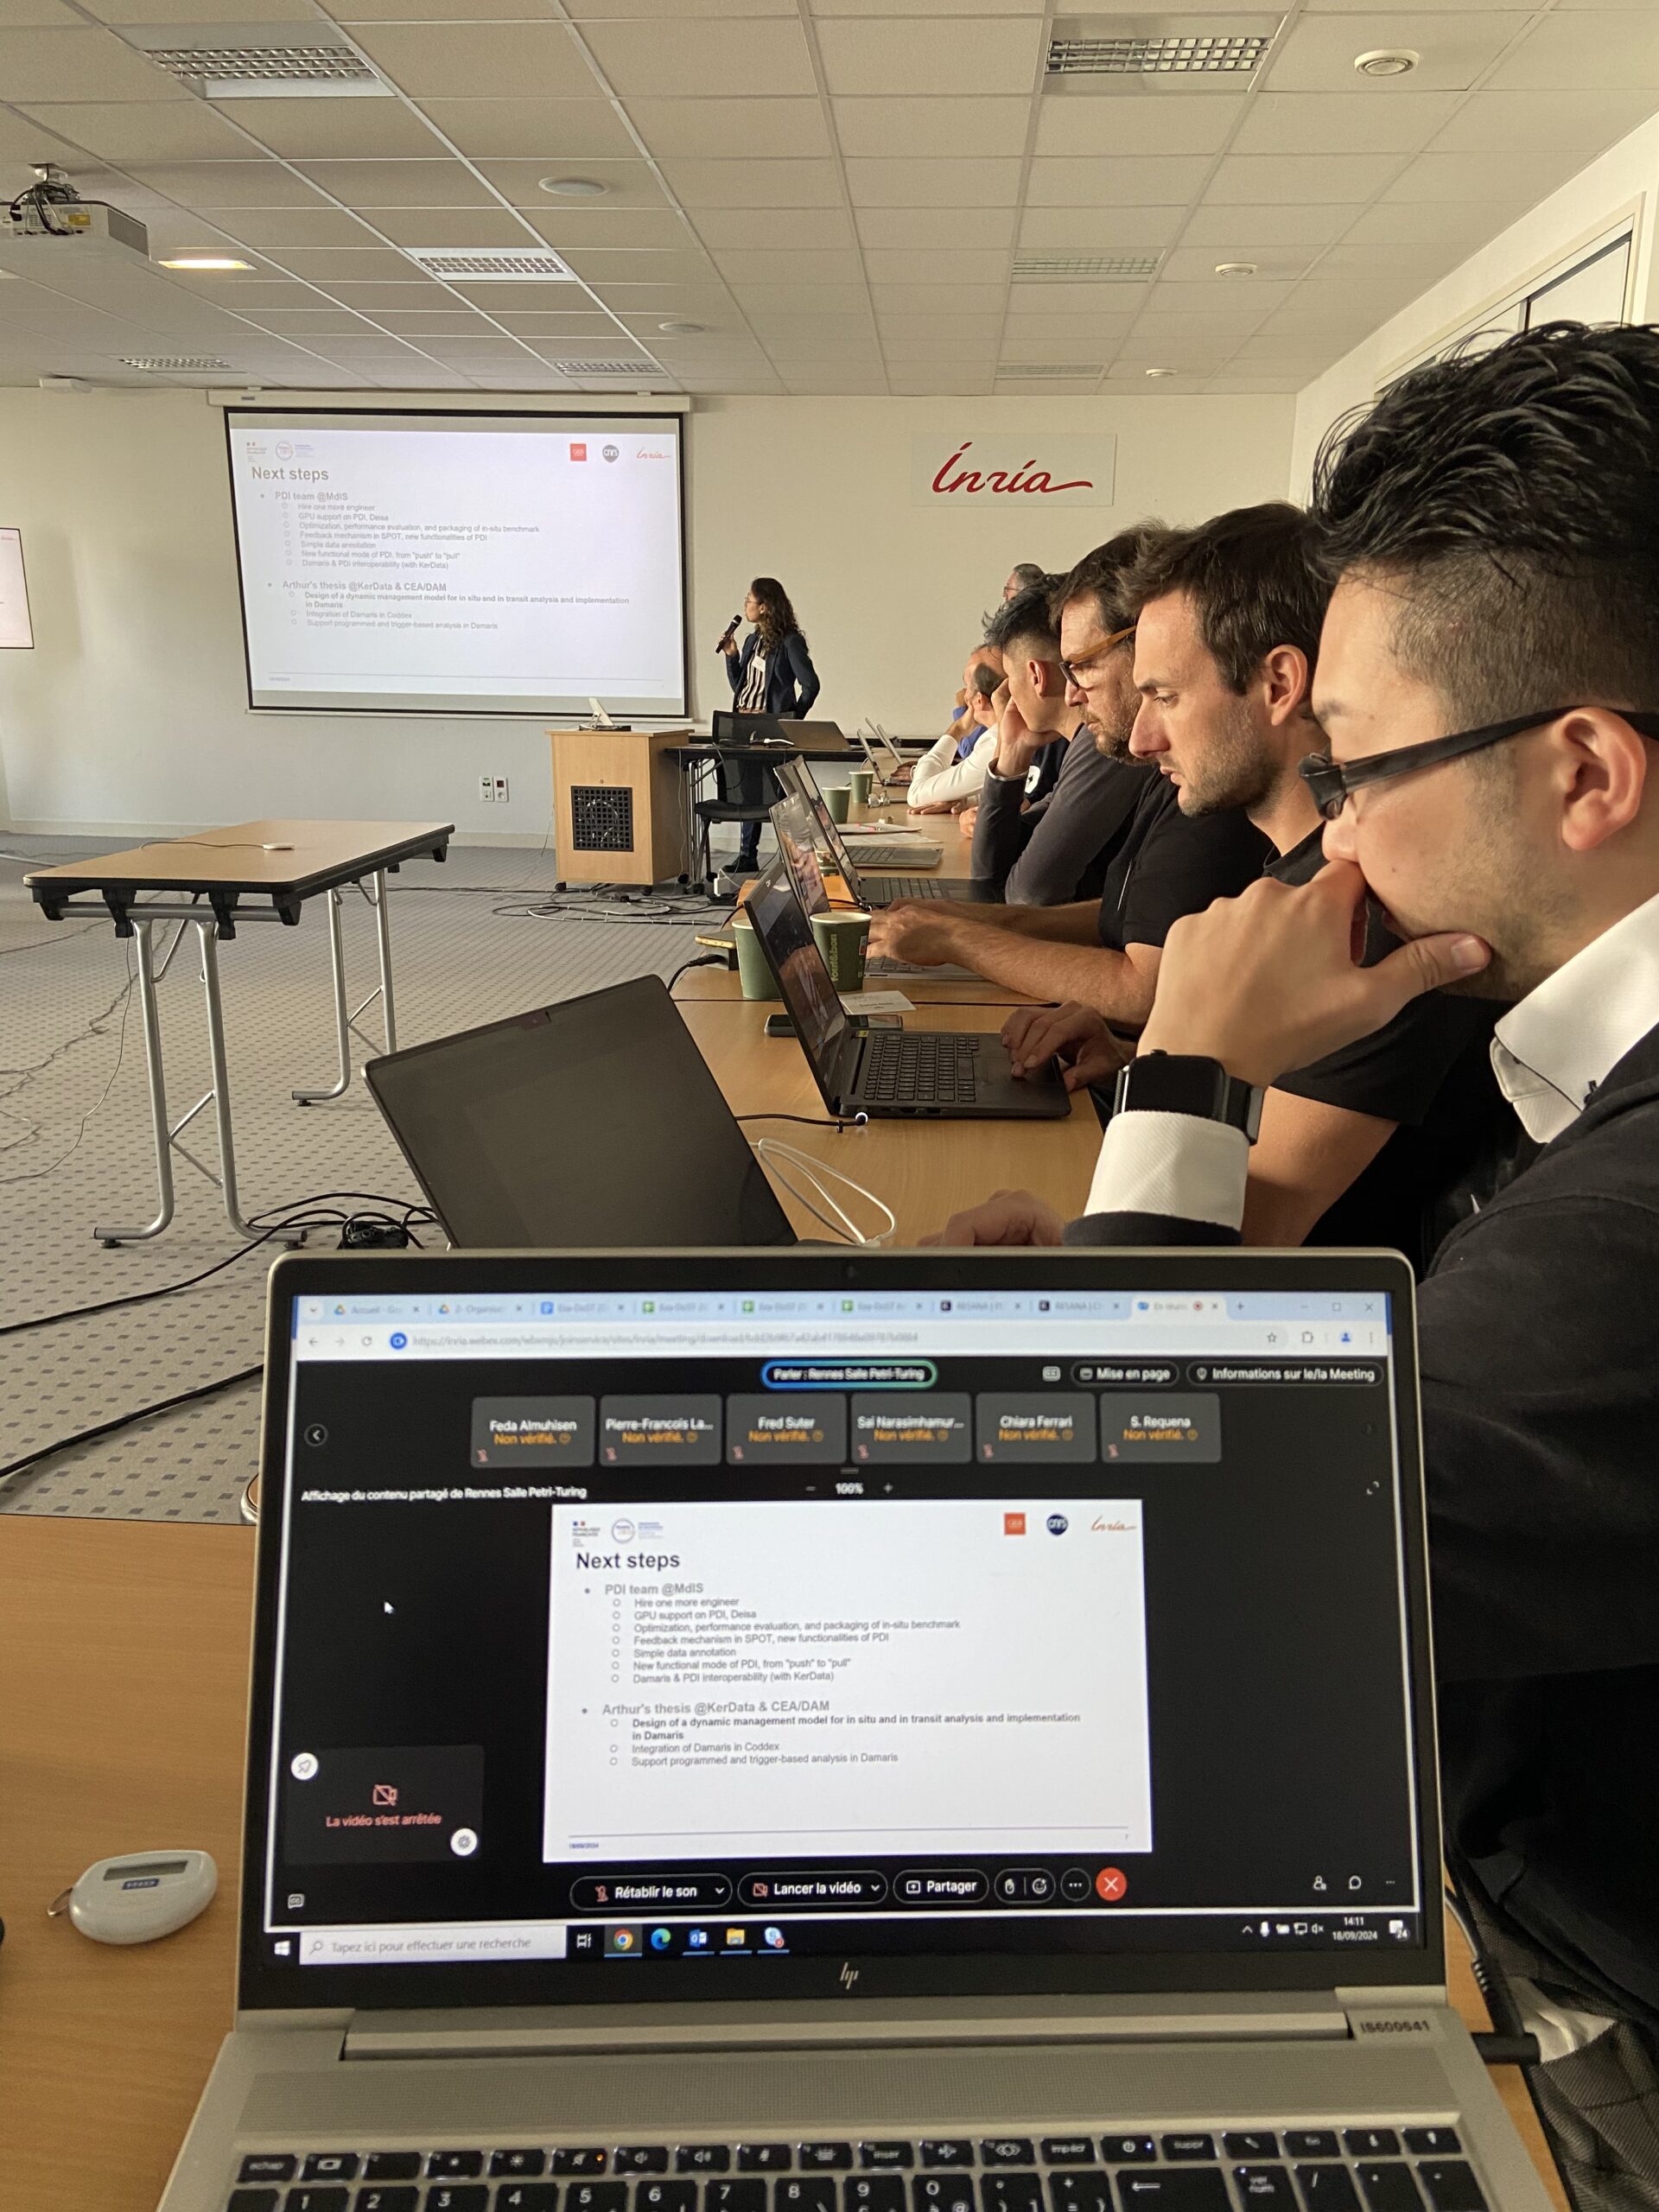
La deuxième réunion annuelle du projet NumPEx Exa-DoST s’est tenue à l’Inria, à Rennes, les 18 et 19 septembre 2024. Ces deux journées ont été l’occasion de partager les premiers résultats du projet et de discuter des axes de recherche à venir.
Le projet Exa-DoST est l’un des cinq projets ciblés du programme NumPEx ; il se concentre sur les défis posés par le stockage, le traitement et l’analyse des données dans le contexte de l’émergence du calcul exascale en Europe. L’objectif est de tirer parti de technologies de stockage innovantes et de prendre en charge des flux de travail hybrides complexes associant simulation, analyse et apprentissage, fonctionnant à des échelles extrêmes sur des supercalculateurs interconnectés à des systèmes cloud et en périphérie.
La deuxième réunion annuelle du projet Exa-DoST s’est tenue à l’Inria, à Rennes, les 18 et 19 septembre 2024. Elle a rassemblé les participants au projet (chercheurs, ingénieurs, étudiants) dans le but de définir une vision commune et partagée des objectifs, des activités et de la stratégie du projet. Elle comprenait également des ateliers spécifiques axés sur l’identification des exigences complexes des applications en matière de stockage et d’analyse des données. Pour la première fois, des membres du Comité consultatif scientifique d’Exa-DoST et du Comité consultatif industriel et technologique ont participé à une réunion globale d’Exa-DoST.
Mercredi 18 septembre 2024
La première journée a été consacrée à des présentations donnant un aperçu des objectifs et des activités du projet dans les différents domaines spécifiques couverts par les work packages techniques. Ces présentations ont été suivies d’une discussion sur la manière dont les activités réalisées dans le cadre de ces work packages (WP) pouvaient interagir entre elles.
-
- Introduction à NumPEx et Exa-DoST
par Gabriel Antoniu, chercheur Inria et co-leader Exa-DoST
et Julien Bigot, chercheur CEA et co-leader Exa-DoST - Objectifs et état d’avancement des work packages :
- WP1 – Stockage et E/S
par Francieli Boito, chercheur à l’Inria et responsable du WP Exa-DoST
et François Tessier, chercheur à l’Inria et responsable du WP Exa-DoST - WP2 – Traitement in situ
Par Yushan Wang, chercheur au CEA et responsable du WP Exa-DoST
et Laurent Colombet, chercheur au CEA et responsable du WP Exa-DoST - WP3 – ML-based analytics
par Thomas Moreau, chercheur à l’Inria et responsable du WP Exa-DoST
et Bruno Raffin, chercheur à l’Inria et responsable du WP Exa-DoST - WP4 – Application illustrator :
par Virginie Grandgirard, chercheur au CEA et responsable du WP Exa-DoST
et Damien Gratadour, professeur à l’Université Paris Cité et responsable du WP Exa-DoST.
- WP1 – Stockage et E/S
- Introduction à NumPEx et Exa-DoST
- Session sur l’interaction inter-WP
animée par Gabriel Antoniu et Julien Bigot
Jeudi 19 septembre 2024
-
- Présentation des séances de brainstorming en parallèle «
» par Julien Bigot - Session sur le Codex
par Laurent Colombet - Conférence de Virginie Grandgirard sur « Gysela »
- Séance sur le SKA
par Laurent Colombet
- Présentation des séances de brainstorming en parallèle «
-
- WP1 «
» (L’impact de la politique de l’emploi sur la croissance économique), par Francieli Boito et François Tessier - WP2 «
» (Analyse de la résistance des structures en béton armé), par Yushan Wang et Laurent Colombet - WP3 «
» (L’impact de la technologie sur la société), par Thomas Moreau et Bruno Raffin
- WP1 «
Les participants ont jugé ces échanges particulièrement fructueux et ont décidé de poursuivre ce travail à travers une série de réunions en ligne et en présentiel.
Participantes et participants
- Gabriel Antoniu, chercheur à l’Inria et responsable du projet Exa-DoST
- Rosa Badia, titulaire d’une licence (BSC) et membre du conseil d’administration d’Exa-DoST
- Thomas Badts, Inria
- Andrés Bermeo Marinelli, de l’Inria et membre d’Exa-DoST
- Julien Bigot, responsable du CEA et d’Exa-DoST
- Francieli Boito, responsable du groupe de travail Inria et Exa-DoST
- Silvina Caino-Lores, de l’Inria et membre d’Exa-DoST
- Damien Chapon, du CEA et membre d’Exa-DoST
- Laurent Colombet, CEA et responsable du groupe de travail Exa-DoST
- Almuhisen Feda, CEA et membre d’Exa-DoST
- Chiara Ferrari, de l’Observatoire de la Côte d’Azur et membre du conseil d’administration d’Exa-DoST
- Virginie Grandgirard, du CEA et responsable du groupe de travail Exa-DoST
- Damien Gratadour, Université Paris Cité et responsable du lot de travail Exa-DoST
- Gabriel Hautreux, chercheur au CINES et membre du conseil d’administration d’Exa-DoST
- Nicolas Lardjane, CEA et membre du conseil d’administration d’Exa-DoST
- Pierre-François Lavallée, du CNRS et membre du conseil d’administration d’Exa-DoST
- Jakob Luettgau, de l’Inria et membre d’Exa-DoST
- Benoît Martin, du CEA et membre d’Exa-DoST
- François Mazen, de Kitware et membre du conseil d’administration d’Exa-DoST
- Yann Meurdesoif, du CEA et membre du conseil d’administration d’Exa-DoST
- Dorian Midou, CEA et membre d’Exa-DoST
- Shan Mignot, du CNRS et membre d’Exa-DoST
- Julien Monniot, de l’Inria et membre d’Exa-DoST
- Thomas Moreau, responsable du WP Inria et Exa-DoST
- Sai Narasimhamurthy, de ParTec et membre du conseil d’administration d’Exa-DoST
- Étienne Ndamlabin, de l’Inria et membre d’Exa-DoST
- Jean-François Nezan, INSA
- Thomas Noël, interlocuteur de l’ANR et d’Exa-DoST
- Kevin Obrejan, CEA et membre d’Exa-DoST
- Guillaume Pallez, de l’Inria et membre d’Exa-DoST
- Lucas Pernollet, chercheur au CEA et chef de projet chez NumPEx
- Cédric Prigent, de l’Inria et membre d’Exa-DoST
- Abhishek Purandare, de l’Inria et membre d’Exa-DoST
- Bruno Raffin, Inria et responsable du groupe de travail Exa-DoST
- Stéphane Requena, Genci et membre du conseil d’administration d’Exa-DoST
- Kento Sato, du Riken et membre du conseil d’administration d’Exa-DoST
- Frédéric Suter, du CNRS et membre du conseil d’administration d’Exa-DoST
- François Tessier, Inria et responsable du groupe de travail Exa-DoST
- Lever de soleil Wang, Observatoire de la Côte d’Azur
- Yushan Wang, CEA et responsable du groupe de travail Exa-DoST
© Lucas Pernollet

NumPEx newsletter n°1 - Premiers éclairages sur le programme NumPEx !
Redirection vers la newsletter... Si rien ne se passe, cliquez ici.
2023 Rapport annuel d'Inria : NumPEx, un programme visant à renforcer les capacités de calcul exascale
Publié en juin dernier, le rapport annuel de l’Institut national de recherche en sciences et technologies du numériques (Inria) nous offre un panorama des actions et résultats de recherche de leurs équipes et laboratoires. Désigné en 2024 comme le coordinateur de l’Agence de programmes « Numérique logiciel », Inria est un acteur incontournable de la recherche française en sciences informatiques. Inria œuvre pour inscrire la France dans la dynamique européenne via la recherche et l’innovation de ses équipes-projets et des collaborations avec les autres organismes de recherche.
Parmi les temps forts d’Inria en 2023, nous retrouvons un panel des programmes de recherche France 2030 co-pilotés par Inria, dont fait partie NumPEx !
Retrouvez-nous page 10 du rapport annuel 2023.
2023 – Rapport d’activité Inria (version française)
2023 – Annual Report Inria (version anglaise)
© Guillaume Martel / CEA
NumPEx en vedette dans le rapport annuel 2023 de GENCI
Dans le domaine de la recherche et de l’innovation, GENCI est un acteur clé dans le paysage du calcul haute performance (HPC) en France. Créée en 2007, elle a pour mission de mettre à la disposition de la communauté scientifique française des ressources de calcul intensif parmi les plus puissantes au monde, notamment les supercalculateurs Jean Zay, Joliot Curie et Adastra. Ces ressources permettent aux scientifiques d’effectuer des simulations numériques complexes et d’analyser des volumes massifs de données, ce qui est crucial pour les avancées dans divers domaines tels que la climatologie, la physique des particules, la biologie et bien d’autres encore.
Récemment, GENCI a publié son rapport d’activité 2023, et l’un des faits marquants de l’année a été le lancement de NumPEx !
Retrouvez NumPEx à la page 20 du rapport d’activité 2023 du GENCI.
2023 – Annual Report GENCI (version anglaise)
2023 – Rapport d’activité GENCI (version française)
© Cyril FRESILLON / IDRIS / CNRS Images
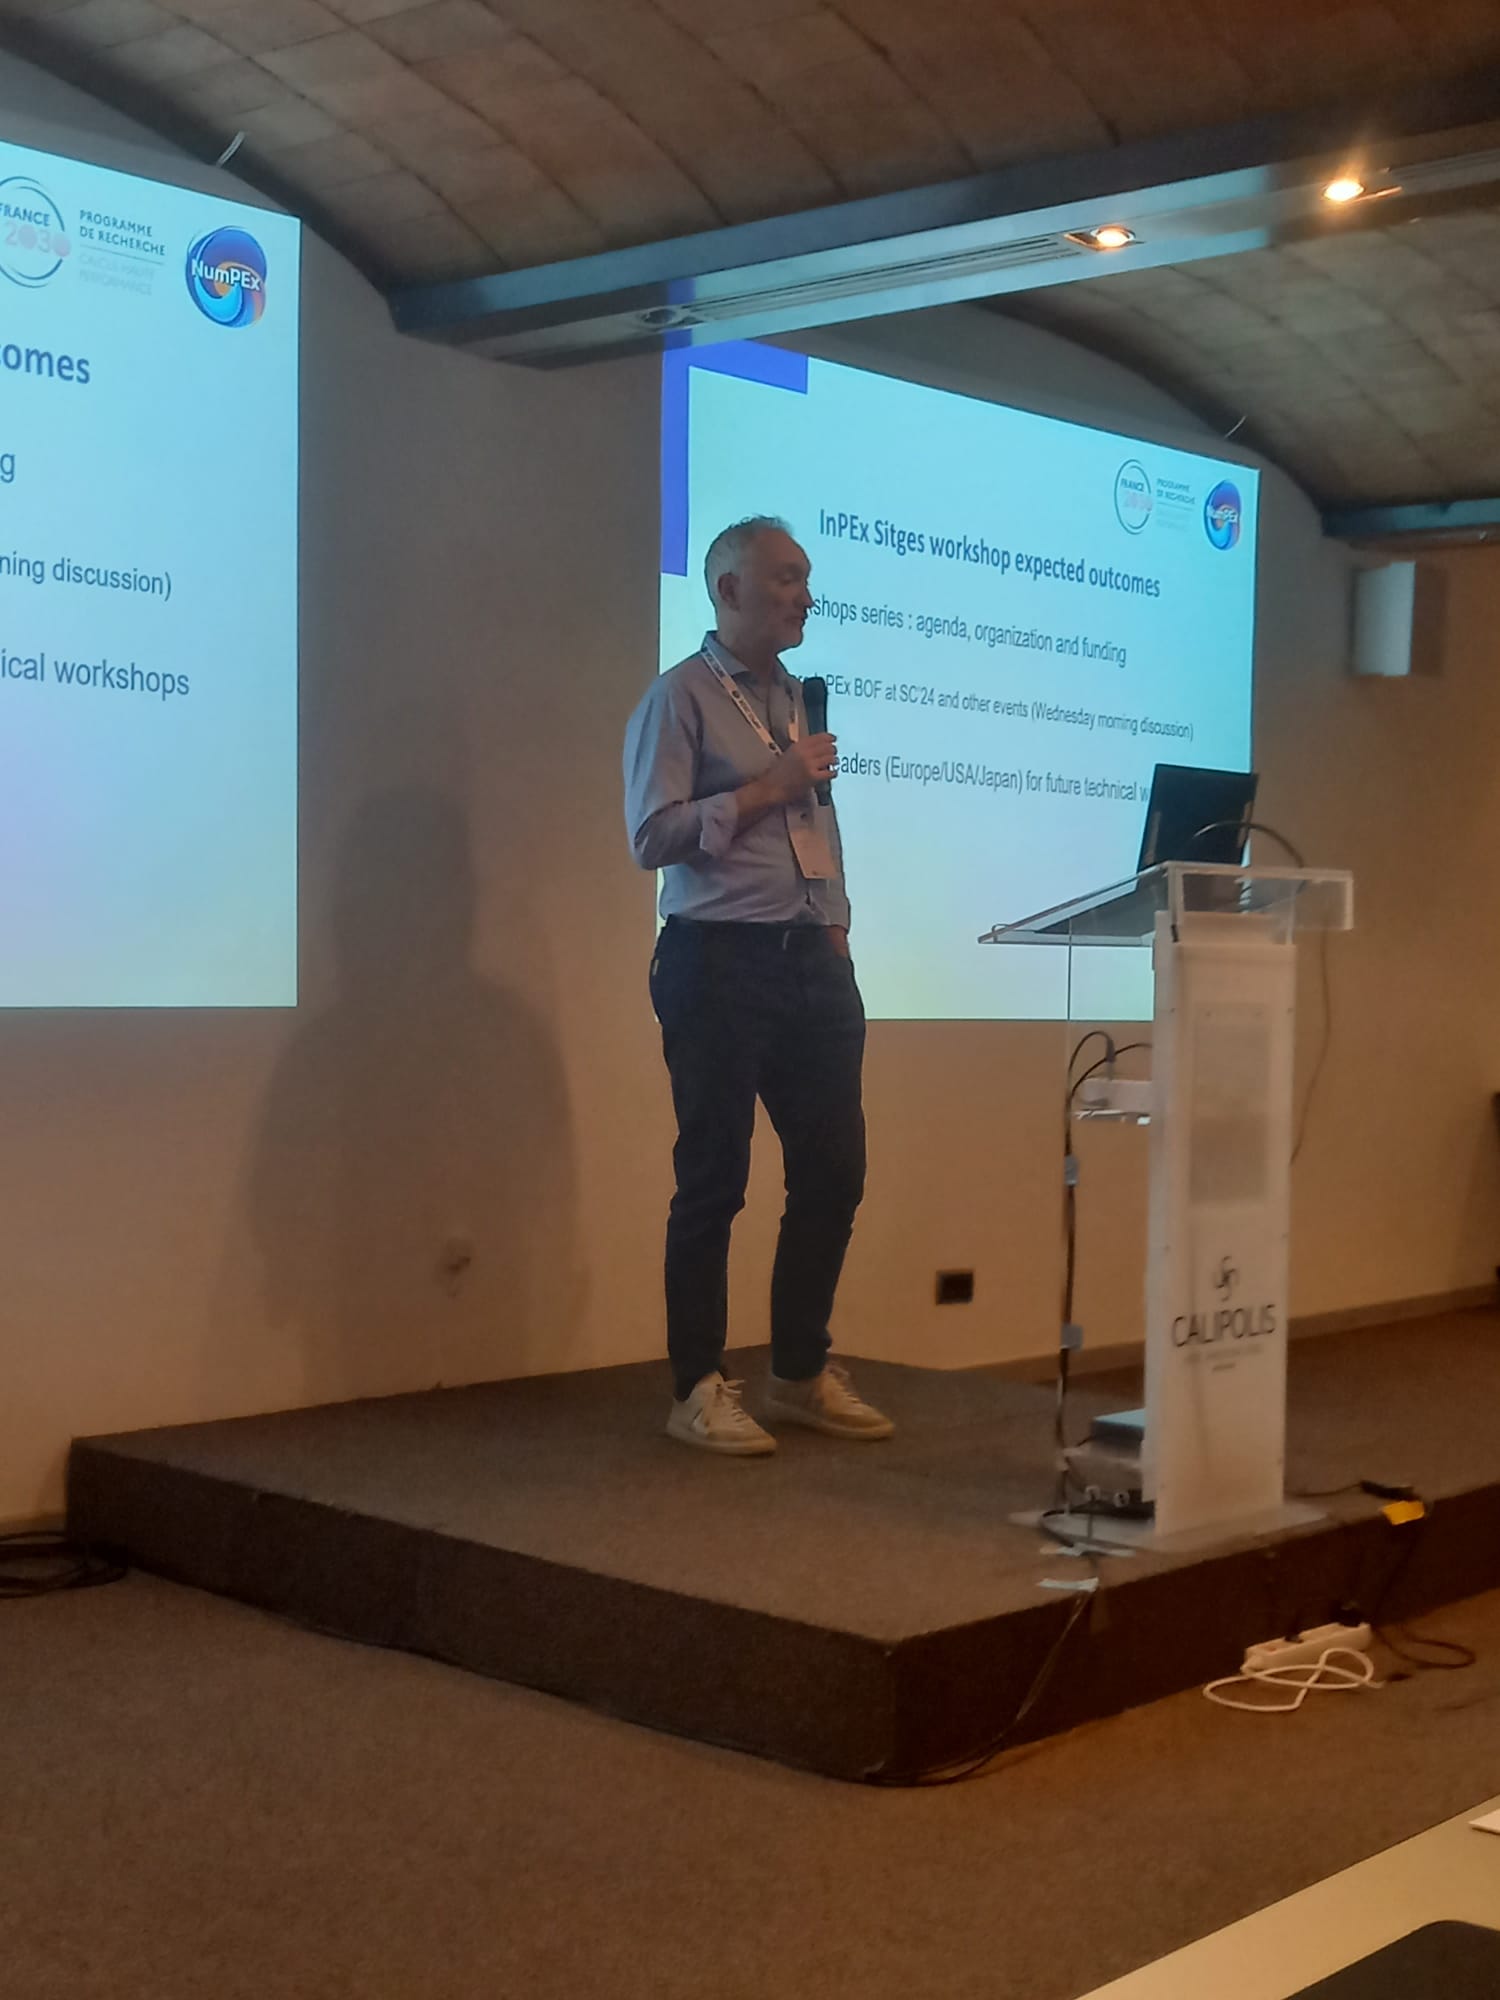
2024 Atelier InPEx
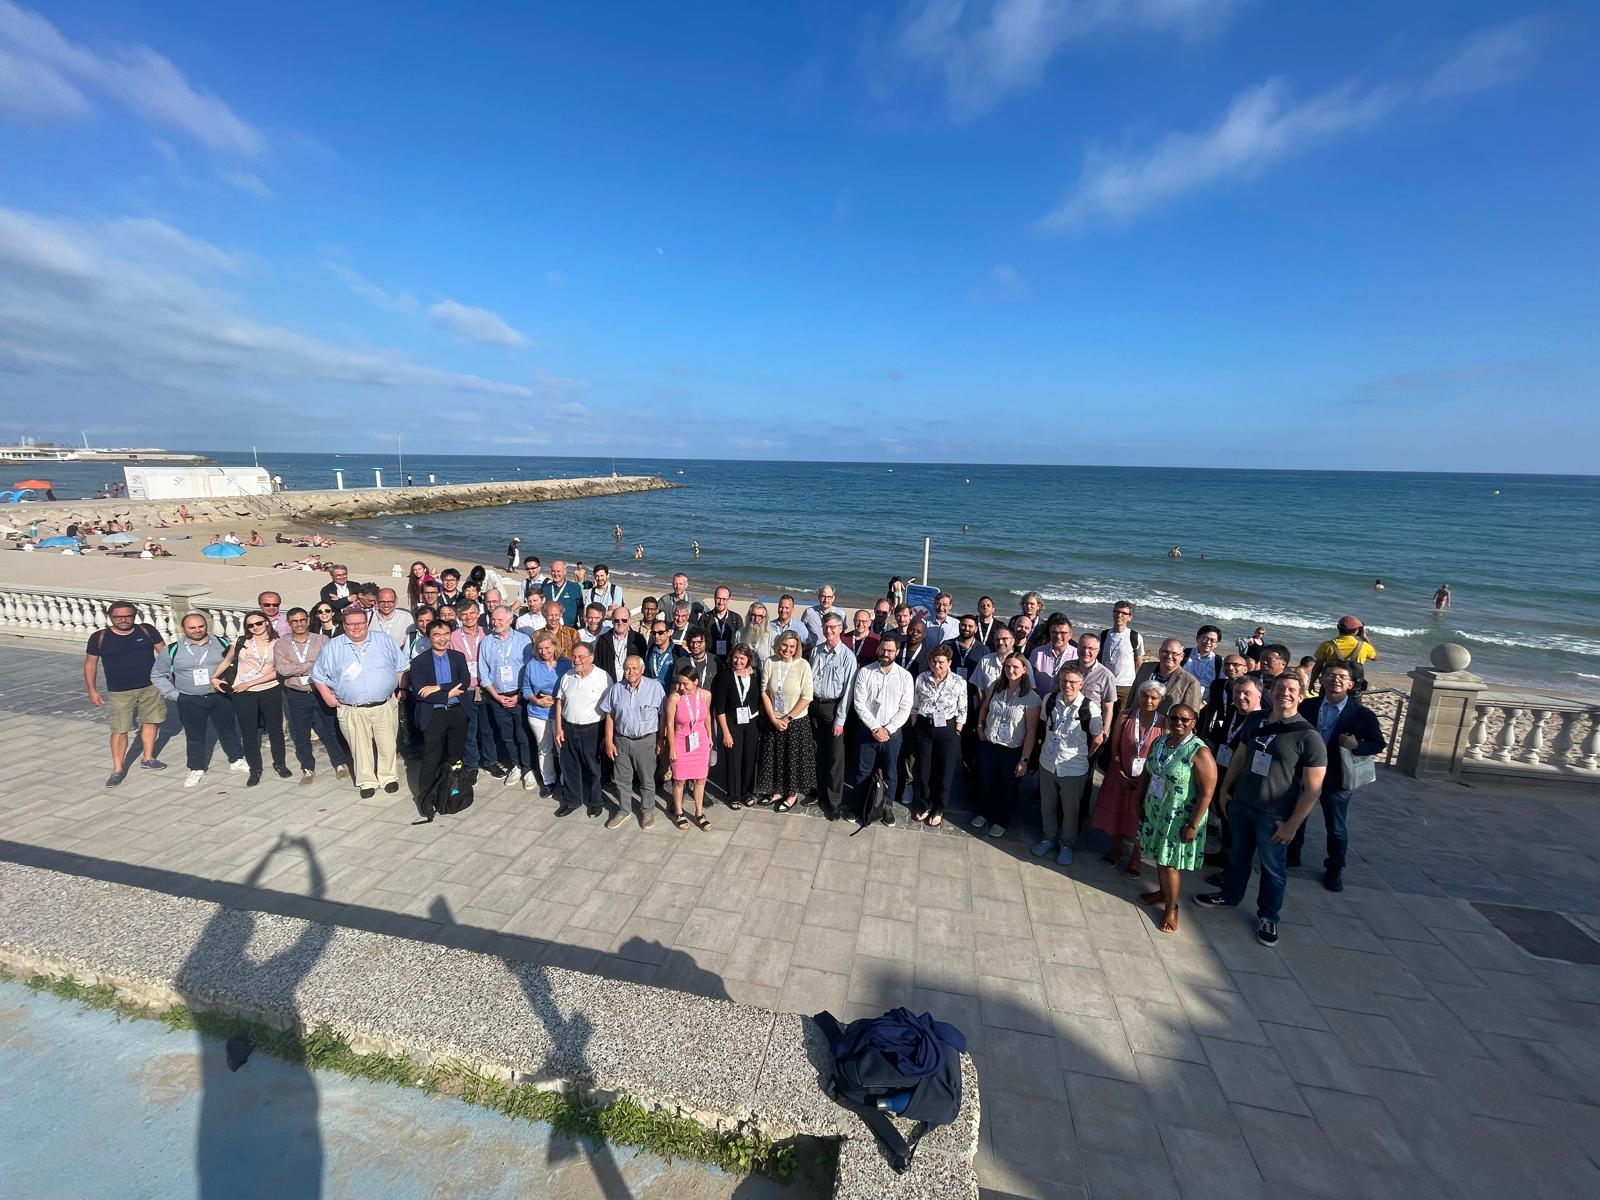
Le Le Barcelona Supercomputing Center et NumPEx ont été ravis d’accueillir la communauté InPEx à Sitges, en Espagne. Du 17 au 19 juin, cet atelier a réuni une centaine d’experts en calcul haute performance (HPC) venus d’Europe, du Japon et des États-Unis.
Cet événement a constitué l’occasion idéale de discuter de l’état de l’art, des projets et du programme relatifs à l’exascale et à l’après-exascale, de présenter les dernières réalisations des groupes de travail de l’InPEx depuis l’atelier de 2023, et de travailler ensemble sur les prochaines étapes de l’InPEx.
Si vous souhaitez en savoir plus, toutes les présentations sont disponibles sur le site web d’InPEx.
Crédit photo : Corentin Lefevre/Neovia Innovation/Inria
Premier workshop du groupe de travail Accelerator de NumPEx
Les 12 et 13 juin 2024, le groupe de travail Accélérateur a organisé l’atelier « Programmation GPU » pour faire un premier bilan de la situation actuelle.
Ce workshop a été l’occasion idéale d’avoir une vue d’ensemble des différentes approches actuellement disponibles pour une utilisation efficace des GPU, y compris la programmation directe, les bibliothèques, les cadres et les méthodes basées sur les tâches.
L’atelier a permis aux participants de repartir avec une compréhension claire des avantages et des inconvénients de chaque approche et de bénéficier d’idées et d’expériences avec différents codes dans le cadre de ces approches.
Vous trouverez ci-dessous tous les documents de présentation et les enregistrements vidéo de la journée, qui s’est déroulée en français.
Introduction et contexte
Ces deux interventions ont été présentées par Samuel Thibault, professeur à l’Université de Bordeaux
Vue d'ensemble des approches GPU
- Cadre « Approche » : Arcane, accélérateur d’API
Gilles Grospellier, chercheur au CEA - Approche par bibliothèques : Programmation GPU à l’aide de bibliothèques scientifiques externes
Florent Pruvost, chercheur à l’Inria - Approche linguistique : Kokkos / OpenMP
Julien Bigot, chercheur au CEA - Approche par tâches, StarPU
Samuel Thibault, professeur à l’Université de Bordeaux
Session Retex : retour d'information et expériences
- Retex – Approche tâches pour l’algèbre linéaire GPU + distribué
Antoine Jego, professeur à la Sorbonne Université - Retex – Approche tâches pour l’algèbre linéaire GPU + I/O, out-of-core, composition (Chameleon)
Florent Pruvost, chercheur à l’Inria - Retex – Approche OpenACC : YALES2
Vincent Moureau, chercheur au CNRS - Retex – Approche OpenACC : Portage d’un code Fortran CFD HPC vers (AVBP)
Joeffrey Legaux, ingénieur au CERFACS - Retex – Approche Kokkos : Dyablo, Un nouveau code AMR agnostique pour Exascale utilisant Kokkos
Arnaud Durocher, chercheur et ingénieur au CEA - Retex – Rust et OpenCL pour le portage GPU (minicl)
Philippe Helluy, professeur à l’Université de Strasbourg
Contributions au programme NumPex et appel à propositions
- Contributions prévues au sein du PEPR NumPEx
Samuel Thibault, professeur à l’Université de Bordeaux - Brainstorming sur l’appel à propositions du GPU
Image de titre : © George Kedenburg / Unsplash